Willkommen in der Welt der mobilen Apps, in der es sich anfühlt, als würdest du mit einem Dutzend Bällen gleichzeitig jonglieren, wenn du hohen Traffic und riesige Datenmengen bewältigen musst!
Mit der Nutzerzahl wächst auch der Aufwand, eine App stabil am Laufen zu halten, besonders bei Social-, Streaming- oder Marktplatz-Apps mit großer Nutzerbasis, wie dir jedes Unternehmen für App-Entwicklung bestätigen wird. Nutzer machen sich außerdem Gedanken darüber, wie man mobile Apps absichert und wie ihr Erlebnis mit der App besser wird.
Genau hier hilft Datenbankoptimierung. Sie verschafft deiner Software mehr Performance und Skalierbarkeit und verbessert damit das Nutzererlebnis. Gleichzeitig ist sie eine Antwort auf die Frage, wie sich die Performance mobiler Apps verbessern lässt.
Jetzt kommen wir zum Kern dieses Leitfadens: Datenbankoptimierung für stark genutzte mobile Apps. Wir sehen uns die Herausforderungen großer Datenmengen an, zeigen, wie Queries schneller laufen, und räumen lästige Engpässe aus dem Weg.
Dann ist es Zeit, deine App in die Welt zu bringen und zuzusehen, wie Nutzer mit einem breiten Grinsen durch dein digitales Universum swipen.
Die Grundpfeiler der Datenbankoptimierung
Datenbankoptimierung ruht auf mehreren Pfeilern, die für Performance, Skalierbarkeit und Effizienz gleichermaßen wichtig sind. Hier sind die wichtigsten.
1. Normalisierung
Bei der Normalisierung geht es darum, Daten in sinnvolle Tabellen aufzuteilen und Duplikate zu vermeiden.
Ziel der Normalisierung ist es, Redundanzen und unnötige Abhängigkeiten zu beseitigen. So steigt die Datenintegrität, und das Risiko von Anomalien beim Ändern der Daten sinkt.
Erste Normalform (1NF): Spalten einer Tabelle in 1NF enthalten nur atomare, nicht weiter teilbare Werte. Außerdem müssen die Spalten eindeutig benannt und jede Zeile eindeutig sein. Damit ist ausgeschlossen, dass mehrere Werte in einer einzigen Zelle landen, und die Daten liegen sauber in Tabellenform vor.
Zweite Normalform (2NF): 2NF baut auf 1NF auf und stellt sicher, dass alle Nicht-Schlüsselattribute voll funktional vom gesamten Primärschlüssel abhängen, nicht nur von einem Teil davon. Das beseitigt partielle Abhängigkeiten und weitere Duplikate derselben Daten.
Dritte Normalform (3NF): 3NF geht einen Schritt weiter und beseitigt transitive Abhängigkeiten. Alle Nicht-Schlüsselattribute dürfen nur vom Primärschlüssel abhängen, nicht von anderen Nicht-Schlüsselattributen. So verschwinden versteckte Beziehungen zwischen Attributen und damit auch wiederholte Daten.
2. Das passende Datenbanksystem wählen
Bei der Wahl der Datenbank solltest du relationale Systeme wie PostgreSQL, MySQL und SQL Server mit NoSQL-Alternativen wie MongoDB und Cassandra vergleichen. Entscheidend sind vor allem deine Datenstruktur und die Art deiner Queries.
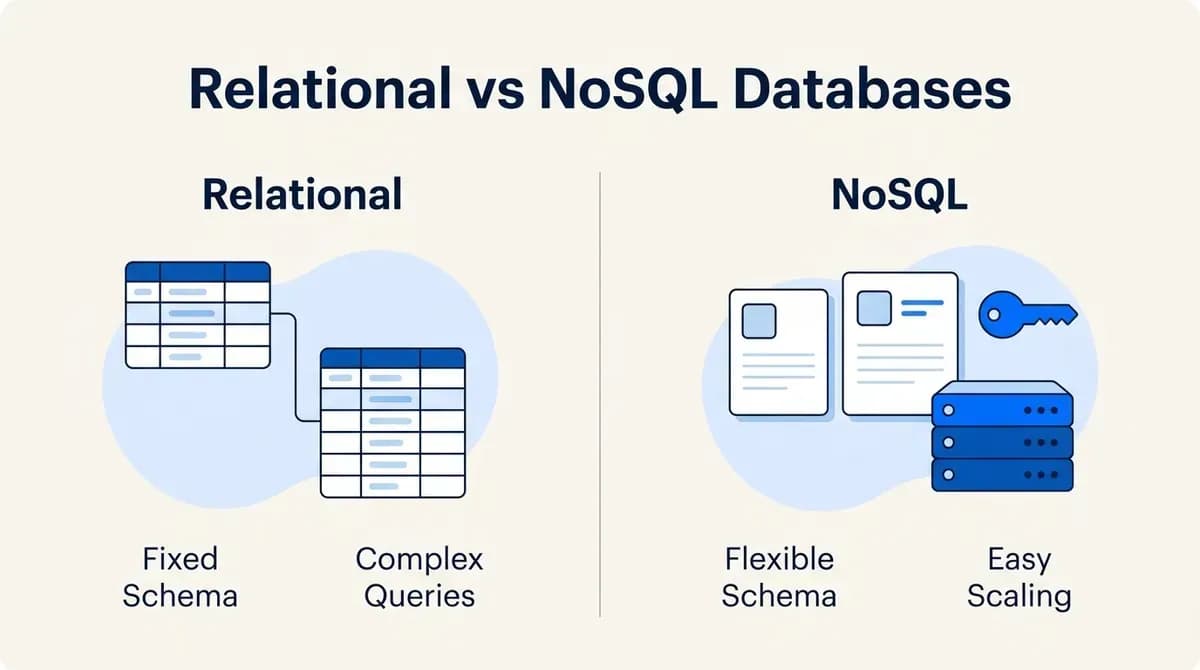
Relationale Datenbanken (PostgreSQL, MySQL und SQL Server)
Strukturierte Daten: Eine große Stärke relationaler Datenbanken ist die Verwaltung strukturierter Daten mit klar definierten Schemas. Wenn deine Daten strukturiert sind und du viele Beziehungen zwischen Entitäten abbilden musst, sind relationale Datenbanken die beste Wahl.
ACID-Konformität: ACID (Atomicity, Consistency, Isolation, Durability): Diese Eigenschaften garantieren Datenintegrität und konsistente Transaktionen. Das verschafft diesen Systemen einen Vorteil überall dort, wo Datenintegrität zählt, etwa im Banking oder im E-Commerce.
SQL-Unterstützung: Relationale Datenbanken nutzen SQL (Structured Query Language), eine mächtige und universelle Sprache für die Arbeit mit Daten. Wenn dein Team SQL beherrscht oder deine Anwendung komplexe Abfragen braucht, sind relationale Datenbanken die richtige Wahl.
NoSQL-Optionen (MongoDB, Cassandra)
Flexibles Schema: Während relationale Datenbanken wie MySQL, Oracle und PostgreSQL eine feste Struktur mit vordefinierten Schemas haben, bieten NoSQL-Datenbanken wie MongoDB und Cassandra flexible Schemas für semistrukturierte und unstrukturierte Daten. Diese Flexibilität ist besonders hilfreich, wenn sich Anforderungen ändern oder die Daten sehr unterschiedlich sind.
Skalierbarkeit: NoSQL-Datenbanken sind auf horizontale Skalierung ausgelegt und eignen sich deshalb ideal für sehr viele Datenpunkte und hohe Lasten. MongoDB und Cassandra sind besonders für ihre verteilte Architektur und die unkomplizierte Skalierung über mehrere Knoten bekannt.
Abfragemuster: NoSQL-Datenbanken sind für bestimmte Abfragearten optimiert, zum Beispiel Dokumentabfragen (MongoDB), Wide-Column-Abfragen (Cassandra) und Key-Value-Lookups (Redis, DynamoDB). Bei Anwendungen, die Daten hauptsächlich als Key-Value-Paare oder Dokumente speichern, übertreffen NoSQL-Datenbanken relationale Systeme bei Performance und Skalierbarkeit.
Wenn du zwischen relationalen Datenbanken und NoSQL wählst, überleg dir, welche Daten du hast, wie du sie abfragst und wie stark dein System skalieren muss.
Relationale Datenbanken sind für strukturierte Daten und komplexe Abfragen gemacht, NoSQL-Datenbanken dagegen für Flexibilität, Skalierbarkeit und optimierte Abfragemuster.
Am Ende hängt die Entscheidung von den konkreten Anforderungen und Grenzen deines Projekts ab.
3. Verteilte Datenbanken
Bei einer verteilten Datenbankarchitektur liegen die Daten nicht auf einem einzigen Server, sondern verteilt auf mehreren Servern oder Knoten. Entstanden ist dieser Ansatz, um sehr große Datenmengen bewältigen zu können.
Riesige Datenmengen: Gerade bei modernen Webdiensten wächst die Menge an erzeugten und gespeicherten Daten enorm. Diese Datenflut kann einen einzelnen Server beim Speichern, Verarbeiten und Verwalten schnell überfordern.
Skalierbarkeit: Verteilte Datenbanken lösen das Problem großer Datenmengen, indem sie die Last auf mehrere Server oder Knoten verteilen. Daten und Rechenlast werden geteilt, sodass du horizontal skalieren kannst: Bei wachsenden Datenmengen und Nutzeranforderungen fügst du einfach weitere Server hinzu.
Lastverteilung: Verteilte Datenbanken verteilen Daten und Verarbeitungsaufgaben auf mehrere Server, damit kein einzelner Server zum Engpass wird. Jeder Server übernimmt einen Teil der Daten und der Last, und gemeinsam bewältigen sie die Datenbank und die Nutzeranfragen effizient.
Fehlertoleranz: Verteilte Datenbanken bieten oft Redundanz und Fehlertoleranz, um Verfügbarkeit und Zuverlässigkeit der Daten sicherzustellen. Fällt ein Server aus oder bricht das Netzwerk ab, läuft das System ohne Unterbrechung weiter, weil alle Anfragen auf die verfügbaren Server umgeleitet werden und die Daten konsistent bleiben.
Wie funktioniert Datenbankoptimierung?
Die grundlegenden Optimierungsmethoden bilden das Fundament der Datenbankoptimierung. Mit ihnen können Unternehmen das volle Potenzial ihrer Dateninfrastruktur ausschöpfen.
Eine Methode ist die Indizierung, eine andere die Partitionierung, und jede unterstützt eigene Abläufe, um Engpässe zu beseitigen und die Performance zu steigern.
Im Mittelpunkt stehen die zentralen Optimierungsprinzipien der Datenbankverwaltung. Wir sehen uns an, was jede Methode zur Performance, Skalierbarkeit und Effizienz einer App beiträgt.
Wer diese Optimierungsstrategien beherrscht, kann seine Datenbanken gezielt nutzen, um in der heutigen datengetriebenen Welt Innovation, Agilität und Wettbewerbsvorteile voranzutreiben.
Indizierung
Indizierung ist eine der wichtigsten Techniken der Datenbankoptimierung und verbessert die Performance von Abfragen und Datenzugriffen erheblich.
Wenn Datenbankadministratoren die Indizes passend zu Abfragemustern und Performance-Anforderungen entwerfen und pflegen, finden sie die richtige Balance zwischen Vor- und Nachteilen der Indizierung.
Vorteile einer guten Indizierung
Schnellere Abfragen: Eine passend indizierte Spalte beschleunigt SELECT-Abfragen deutlich und verkürzt die Wartezeit beim Abrufen der Daten.
Weniger Full-Table-Scans: Dank Indizes greift die Datenbank direkt auf die benötigten Zeilen zu, ohne die ganze Tabelle zu durchsuchen. Dadurch werden Daten schneller abgerufen.
Höhere Effizienz: Gut entworfene Indizes reduzieren den Aufwand für Datenzugriffe und Abrufe, was die Datenbank insgesamt effizienter macht.
Worauf du bei der Indizierung achten solltest
Auswahl der Spalten: Welche Spalte du indizierst, ist entscheidend. Spalten, die häufig in WHERE-Bedingungen, JOINs und ORDER BY-Klauseln vorkommen, sind gute Kandidaten für einen Index.
Abfragemuster: Wenn du weißt, welche Abfragen auf der Datenbank laufen und für welche Spalten sich ein Index lohnt, verbesserst du die Performance gezielt.
Die richtige Balance: Indizes können Abfragen deutlich beschleunigen, aber zu viele davon sind keine gute Idee: Sie kosten zusätzlichen Speicher und verlangsamen Schreibvorgänge. Die richtige Balance zu finden, solltest du nicht unterschätzen.
Query-Optimierung
Query-Optimierung bedeutet, die Performance und Effizienz von Datenbankabfragen zu verbessern. Dazu gehört, Abfragen und ihre Ausführungspläne zu untersuchen, Engpässe und Ineffizienzen zu finden und Strategien zu entwickeln und umzusetzen, die die Abfragen schneller machen.
Vorteile der Query-Optimierung
Bessere Performance: Gut optimierte Abfragen liefern schneller Ergebnisse, was die Systemleistung verbessert und die Wartezeit für Nutzer verkürzt.
Bessere Skalierbarkeit: Effiziente Abfragen verbrauchen weniger Ressourcen, sodass das System mehr parallele Anfragen ohne Leistungseinbußen bewältigt.
Geringerer Ressourcenverbrauch: Optimierte Abfragen brauchen weniger CPU-Zyklen, Arbeitsspeicher und Disk-I/O, was Ressourcenverbrauch und Betriebskosten senkt.
Besseres Nutzererlebnis: Kürzere Abfragezeiten sorgen für ein flüssiges, interaktives Nutzererlebnis und damit für zufriedenere und engagiertere Nutzer.
Geringere Latenz: Präzise Abfragen senken die Latenz, weil das Abrufen und Verarbeiten der Daten weniger Zeit braucht, und sorgen für schnellere Antwortzeiten bei Nutzern und Anwendungen.
Tools für die Query-Optimierung
EXPLAIN: Erzeugt einen Ausführungsplan, der die einzelnen Datenbankoperationen detailliert beschreibt. So findest du Performance-Engpässe und kannst den Ausführungsplan verbessern.
ANALYZE: Sammelt Statistiken über die Nutzung von Tabellen und Indizes. Damit siehst du, wie die Daten verteilt sind und wie Abfragen performen, und erkennst, wo sich Optimierung lohnt.
Datenbank-Profiler: Zeichnen Datenbankaktivitäten wie langsame Abfragen, ressourcenintensive Operationen und Performance-Engpässe auf, damit du gezielt optimieren kannst.
Query-Tuning-Advisors: Liefern automatische Empfehlungen zur Query-Optimierung, etwa zu besseren Indizes, umgeschriebenen Abfragen und geänderten Konfigurationen.
Visualisierung von Query-Plänen: Stellen Ausführungspläne grafisch dar und zeigen, welche Operationen für die Performance kritisch sind und wo du optimieren solltest.
Skalieren für Wachstum
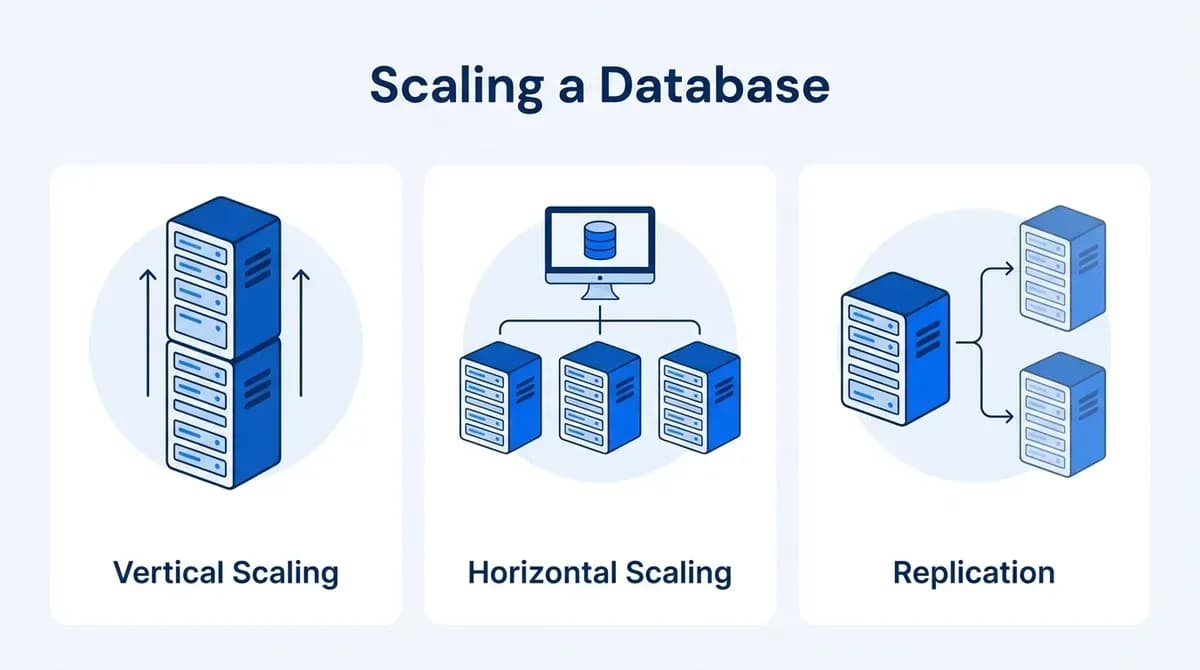
Skalieren für Wachstum heißt, die Kapazität des Systems so zu erweitern, dass es mehr Last bewältigt. Dafür gibt es drei Wege: vertikale Skalierung, horizontale Skalierung und Replikation.
Jede Skalierungstechnik hat Vor- und Nachteile, die Unternehmen sorgfältig abwägen sollten, um die passende für ihre wachsende Infrastruktur zu wählen.
Vertikale Skalierung
Bedeutung: Bei der vertikalen Skalierung, auch Scale-up genannt, erhöhst du die Kapazität eines einzelnen Servers durch mehr CPU, Arbeitsspeicher oder Speicherplatz. Meist bedeutet das, auf einen leistungsstärkeren Server umzusteigen.
Grundsätzliche Grenzen: Vertikale Skalierung stößt irgendwann an harte Grenzen, ab denen weiteres Aufrüsten teuer oder unmöglich wird. Außerdem wird der einzelne Server zum Single Point of Failure, was zu Ausfallzeiten und Datenverlust führen kann.
Horizontale Skalierung (Sharding)
Datenverteilung: Bei der horizontalen Skalierung, auch Scale-out genannt, verteilst du die Daten auf mehrere Server oder Knoten. Sharding ist eine verbreitete Methode dafür: Die Daten werden partitioniert, und jeder Teil liegt als eigener Shard auf einem separaten Server.
Höhere Komplexität: Sharding bringt zusätzlichen Aufwand mit sich: Du musst die Datenverteilung steuern, die Konsistenz über alle Shards sicherstellen und die Shards neu verteilen, wenn das System wächst. Umsetzung und Wartung erfordern sorgfältige Planung und Abstimmung.
Höherer Durchsatz: Dafür verteilt horizontale Skalierung die Last auf mehrere Server, sodass das System mehr gleichzeitige Anfragen bewältigt, ohne einzelne Server zu überlasten.
Replikation
Lesezugriffe verteilen: Damit die Performance auch bei vielen Lesezugriffen hoch bleibt, werden per Replikation Kopien der Datenbank angelegt. Read Replicas übernehmen Leseabfragen von der primären Datenbank, entlasten so den Primärserver und verbessern die Skalierbarkeit.
Vorteile bei vielen Lesezugriffen: Mit Replikation können Anwendungen Leseanfragen horizontal über mehrere Kopien verteilen. So bewältigen sie deutlich mehr Lesezugriffe, ohne die Konsistenz der Schreibvorgänge zu beeinträchtigen.
Failover und Hochverfügbarkeit: Replikation ermöglicht Failover und Hochverfügbarkeit, weil die Daten an zwei verschiedenen Orten vorliegen. Fällt die primäre Datenbank aus, übernimmt die Replica und bedient weiter Anfragen. So bleiben Ausfallzeiten minimal und der Service läuft ohne Unterbrechung.
Fortgeschrittene Themen
Als Nächstes geht es um fortgeschrittene und moderne Möglichkeiten, Datenbanken zu optimieren.
Caching
Die Rolle von In-Memory-Caching: In-Memory-Caches wie Memcached und Redis ermöglichen einen sehr schnellen Datenzugriff, weil sie häufig abgerufene Daten und die Ergebnisse von Datenbankabfragen im Arbeitsspeicher halten.
Best Practices: Identifiziere die Hot Data, leg passende Ablaufzeiten fest und sorge für eine saubere Cache-Invalidierung. So bleiben die Daten konsistent und die Cache-Trefferquote möglichst hoch.
Datenkompression
Einsatz und Vorteile: Kompression entschärft Engpässe bei Disk-I/O, weil die Daten komprimiert gespeichert werden. Das spart Speicherplatz und beschleunigt die Datenübertragung. Besonders lohnt sie sich bei großen Datensätzen mit vielen Wiederholungen, bei denen die Einsparung den zusätzlichen Rechenaufwand übersteigt.
Mögliche Nachteile: Kompression bringt zwar Vorteile bei Speicher und I/O, verursacht aber zusätzliche CPU-Last beim Komprimieren und Dekomprimieren. Mit einem durchdachten Umgang mit CPU-Ressourcen und Datenzugriffen hältst du diese Nachteile klein.
Datenpartitionierung
Mehr Effizienz: Bei der Partitionierung wird eine große Tabelle nach bestimmten Kriterien, etwa Wertebereichen oder Hash-Funktionen, in logische Einheiten aufgeteilt. Die Effizienz steigt, weil die Daten auf mehrere Speichermedien oder Server verteilt sind, parallel verarbeitet werden können und weniger Konflikte beim Zugriff entstehen.
Optimale Umsetzung: Gute Partitionierungsstrategien berücksichtigen Abfragemuster, Zugriffshäufigkeit und Wartungsaufwand, um eine ausgewogene Datenverteilung und schnelle Abfragen zu erreichen.
Analytics auslagern
Separate Datenbanken oder Data Warehouses: Wenn du Analysen in eigene analytische Datenbanken oder Data Warehouses auslagerst, trennst du analytische von transaktionalen Workloads. So konkurrieren sie nicht um Ressourcen, und beide laufen stabil.
Vorteile: Eigene Analyseumgebungen nutzen Hardware und Software, die für komplexe Reports und Analysen großer Datenmengen optimiert sind, ohne die transaktionalen Systeme auszubremsen.
Moderne Datenbankoptionen für Apps mit hohem Traffic
Die Grundlagen oben gelten weiterhin, aber heutige Managed Services nehmen deinem Team viel Arbeit ab:
- Serverless Postgres (Neon, Amazon Aurora Serverless): Die Datenbank skaliert die Rechenleistung mit dem Traffic hoch und runter. Du zahlst in ruhigen Phasen weniger und bewältigst trotzdem Lastspitzen.
- Distributed SQL (CockroachDB, Google Spanner): Relationale Tabellen und SQL, wobei die Daten für Skalierbarkeit und Ausfallsicherheit über mehrere Regionen verteilt sind.
- Connection Pooling (PgBouncer, RDS Proxy): Mobile Apps öffnen viele kurze Verbindungen, und ein Pooler verhindert, dass sie die Datenbank bei Lastspitzen überlasten.
- Managed Caches (Redis-kompatible Dienste wie Valkey und Amazon ElastiCache): In-Memory-Caching, ohne eigene Cache-Server betreiben zu müssen.
Performance-Kennzahlen und Monitoring
Performance-Kennzahlen und Monitoring sind fortlaufende Prozesse, mit denen du das Datenbanksystem an sich ändernde Geschäftsanforderungen und Performance-Erwartungen anpasst.
Wichtige Performance-Kennzahlen
Durchsatz: Misst die Anzahl der Transaktionen oder Abfragen pro Zeiteinheit und zeigt damit, wie viel die Datenbank verarbeiten kann.
Latenz: Die Zeit, die eine Abfrage oder Transaktion bis zur Ausführung braucht, abhängig davon, wie schnell die Datenbank antwortet.
Nebenläufigkeit: Gibt an, wie viele gleichzeitige Operationen oder Abfragen eine Datenbank pro Zeiteinheit verarbeiten kann, ohne langsamer zu werden.
Ressourcenauslastung: Überwacht die Auslastung von CPU, Arbeitsspeicher, Disk-I/O und Netzwerk, um Engpässe zu erkennen und Ressourcen besser zu verteilen.
Tools für das Performance-Monitoring
Tools von Datenbankmanagementsystemen (DBMS): Die meisten Datenbankmanagementsysteme bringen Monitoring-Tools oder Managementkonsolen mit, über die du Performance-Kennzahlen in Echtzeit erfassen kannst.
Monitoring-Lösungen von Drittanbietern: Spezialisierte Tools von Drittanbietern bieten erweiterte Analysen, Alerting und individuell anpassbare Dashboards für die Datenbank-Performance.
Warum Performance-Monitoring wichtig ist
Probleme früh erkennen: Beim Performance-Monitoring fallen Probleme wie langsame Abfragen, Ressourcenengpässe oder Konfigurationsfehler auf, bevor sie zu kritischen Ausfällen werden.
Optimierungspotenzial finden: Durch die Auswertung der Kennzahlen erkennen Administratoren, wo sich Optimierung lohnt, können Konfigurationen feinjustieren und Best Practices umsetzen, um die Datenbank effizienter zu machen.
Kapazitätsplanung: Wer Performance-Kennzahlen über längere Zeit beobachtet, kann die Kapazität planen, den künftigen Ressourcenbedarf abschätzen und die Infrastruktur vorausschauend skalieren.
Best Practices für das Monitoring
Klare Ziele definieren: Leg klare Performance-Ziele und Kennzahlen fest, die zu den benötigten Ressourcen und den Erwartungen deiner Nutzer passen.
Regelmäßig überwachen: Überwache die Kennzahlen in Echtzeit und sammle historische Daten, um Trends, Anomalien und nachlassende Performance zu erkennen.
Alerts und Benachrichtigungen: Richte Alerts ein, die das Team bei kritischen Vorfällen oder Werten außerhalb der üblichen Schwankungsbreite informieren.
Ursachenanalyse: Wenn Performance-Probleme auftreten, führe eine gründliche Ursachenanalyse durch, finde heraus, was das Problem überhaupt möglich gemacht hat, und leite Maßnahmen zur Behebung ein.
Datenbankoptimierung als nie endender Kreislauf
Iterative Optimierung ist ein systematischer Ansatz, um Effizienz, Wirksamkeit und Produktivität eines Systems oder Prozesses durch wiederholte Durchläufe zu steigern. Dieses Vorgehen ermöglicht kontinuierliches Lernen und Anpassen anhand von Feedback und Kennzahlen und führt so Schritt für Schritt zu Verbesserungen.
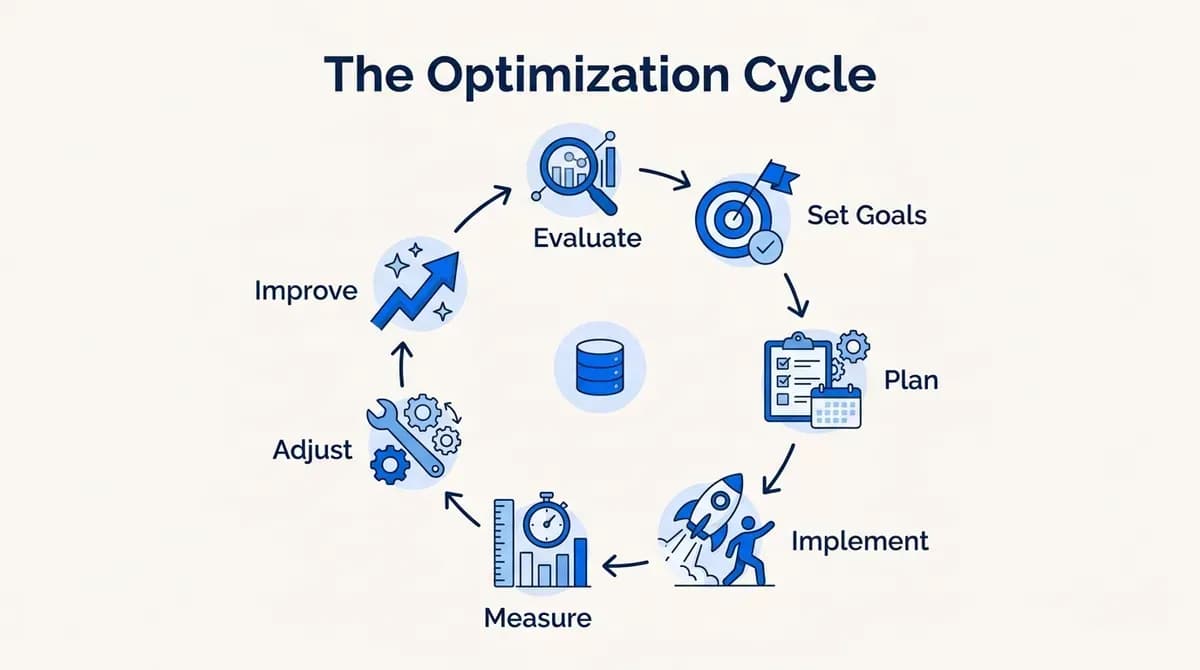
1. Bewertung und Analyse
Aktuelle Performance bewerten: Bewerte die Performance des Systems anhand von Kennzahlen, Engpässen und seinen Grenzen.
Feedback einholen: Hol Feedback von Nutzern, Entwicklern und Stakeholdern ein, um zu erfahren, wo es hakt, welche Performance sie erwarten und was besser werden sollte.
2. Ziele festlegen und priorisieren
Optimierungsziele definieren: Leg Ziele und Performance-Indikatoren fest, die sich aus den Ergebnissen der Bewertung und dem Feedback ergeben.
Optimierung priorisieren: Identifiziere die wichtigsten Performance-Probleme und ordne die Optimierungsarbeit nach ihrem Einfluss auf Nutzererlebnis, Systemstabilität und Geschäftsziele.
3. Strategie entwickeln
Optimierungsstrategien finden: Sammle und recherchiere Methoden, Techniken und Best Practices, mit denen sich diese Performance-Probleme lösen lassen.
Strategien an Ziele anpassen: Richte die Optimierungsstrategien an den festgelegten Zielen, den wichtigsten Problemen und den Eigenschaften deines Datenbanksystems aus.
4. Umsetzung und Tests
Optimierungspläne umsetzen: Setz Optimierungstechniken, Änderungen und Performance-Tuning in der Datenbankumgebung um.
Testen und validieren: Teste und validiere gründlich, ob die umgesetzten Optimierungen die erwarteten Verbesserungen bei Performance und Betriebseffizienz tatsächlich bringen.
5. Monitoring und Messung
Performance-Kennzahlen überwachen: Überwache nach den Optimierungen die wichtigsten Kennzahlen und Indikatoren, um ihre Wirkung auf die Datenbank-Performance zu erkennen.
Ergebnisse messen: Miss den Erfolg der Optimierung, indem du die Ergebnisse mit den gesetzten Zielen und Performance-Vorgaben vergleichst, und halte fest, was gut lief und was nicht.
6. Feedback und Anpassung
Feedback einholen: Sammle Feedback von den wichtigsten Stakeholdern, also Nutzern, Entwicklern und Systemadministratoren, dazu, wie sich die Optimierung auf Systemleistung und Nutzererlebnis auswirkt.
Iterative Anpassung: Passe Optimierungsstrategien und Konfigurationen auf Basis von Feedback und Monitoring schrittweise an, um die Datenbank feinzujustieren und verbleibende Probleme zu lösen.
7. Kontinuierliche Verbesserung
Iterativer Kreislauf: Optimierung ist ein fortlaufender Prozess aus Bewertung, Umsetzung, Tests und Anpassung.
Kontinuierliches Lernen: Nutze die Erkenntnisse aus jedem Schritt der Datenbankoptimierung und dokumentiere, was du gelernt hast, damit jede Optimierungsphase die Performance weiter verbessert.
Fazit
Datenbankoptimierung für eine mobile App mit hohem Traffic zielt auf zufriedene Nutzer und dauerhaft gute Performance. Gezielte Indizierung, Query-Optimierung, Caching und Datenkompression helfen Datenbanken, große Datenmengen schnell zu verarbeiten.
Skalierungstechniken wie (horizontales) Sharding sorgen für zusätzliche Skalierbarkeit, und Echtzeit-Monitoring ermöglicht eine fortlaufende Optimierung der Performance. So lassen sich Datenbanken iterativ verbessern und die Anforderungen von mobilen Anwendungen mit hohem Traffic bewältigen.
Am Ende ist es eine gut entworfene Datenbank, die einer mobilen App Wachstum ohne Leistungseinbußen ermöglicht. Eine individuelle mobile App von Appkodes, deren Datenbank vom ersten Release an für hohen Traffic ausgelegt ist, gibt es ab $8,000, mit einem kalkulierten Plan zum Festpreis vor Projektbeginn, und die meisten ersten Releases gehen in rund 30 Tagen live.
Häufige Fragen
Was ist Datenbankoptimierung?
Die Verbesserung, wie eine Datenbank Daten speichert und abruft, durch Schema-Design, Indizes, Query-Tuning, Caching und Skalierung, damit die App schnell bleibt, wenn Nutzer und Daten wachsen.
Sollte eine mobile App SQL oder NoSQL nutzen?
SQL-Datenbanken wie PostgreSQL eignen sich für strukturierte Daten und Transaktionen, NoSQL-Datenbanken wie MongoDB für flexible oder sehr große Datenmengen. Viele Apps nutzen beides.
Wie beschleunige ich eine langsame Datenbank am schnellsten?
Finde die langsamsten Queries mit EXPLAIN und dem Slow-Query-Log der Datenbank, leg die passenden Indizes an und cache häufig gelesene Daten in Redis oder einem ähnlichen Store.
Wann sollte ich meine Datenbank sharden?
Erst wenn ein einzelner Server deine Schreiblast oder Datenmenge nicht mehr bewältigt. Probier vorher Indizes, Caching, Read Replicas und einen größeren Server, denn Sharding erhöht die Komplexität.
Was kostet die Entwicklung einer App mit hohem Traffic?
Das hängt von den Funktionen und der erwarteten Last ab. Eine individuelle App von Appkodes mit einer auf Skalierung ausgelegten Datenbank gibt es ab $8,000, und die meisten ersten Releases gehen in rund 30 Tagen live.

Arun Andiselvam
LinkedInIch bin Gründer und habe fünf Marken aufgebaut. Die erste, ein SEO-Werkzeug, habe ich für einen sechsstelligen Betrag verkauft, und heute leite ich Appkodes und entwickle individuelle Mobile- und Web-Apps für Gründer und Unternehmen. Jede davon habe ich vom ersten Tag an selbst finanziert.