Bienvenue dans l’univers des applications mobiles, où encaisser un trafic intense et des volumes de données énormes revient à jongler avec une douzaine de balles à la fois !
La difficulté de garder une appli fonctionnelle grandit elle aussi, surtout pour les applis sociales, de streaming ou de marketplace qui comptent une base d’utilisateurs immense, et toute agence de développement d’applications mobiles vous le confirmera. Les utilisateurs se demandent aussi comment sécuriser les applications mobiles et comment améliorer leur expérience.
C’est précisément le rôle de l’optimisation de base de données. Elle donne à votre logiciel un vrai gain de performance et de capacité, au bénéfice de l’expérience utilisateur. C’est aussi une réponse à la question comment améliorer les performances d’une application mobile.
Entrons maintenant dans le cœur de ce guide : l’optimisation de la base de données des applications mobiles très utilisées. Nous verrons les problèmes liés aux grands volumes de données, comment accélérer les requêtes et comment éliminer les goulots d’étranglement les plus gênants.
Il est temps de lancer votre appli et de voir les utilisateurs parcourir votre univers numérique avec un grand sourire.
Les piliers de l’optimisation de base de données
L’optimisation de base de données repose sur plusieurs piliers, tous essentiels pour la performance, la scalabilité et l’efficacité. Voici les principaux.
1. La normalisation
La normalisation consiste à organiser les données en tables cohérentes et à supprimer les doublons.
Son objectif principal est d’éviter la redondance et les dépendances inutiles : l’intégrité des données s’en trouve renforcée et le risque d’anomalies lors des modifications est réduit.
Première forme normale (1NF): en 1NF, chaque colonne contient des valeurs atomiques, impossibles à subdiviser. Les colonnes doivent par ailleurs être distinctes et chaque ligne unique. On ne stocke donc jamais plusieurs valeurs dans une même cellule, ce qui donne des données réellement tabulaires.
Deuxième forme normale (2NF): la 2NF prolonge la 1NF en exigeant que tous les attributs non clés dépendent entièrement de la clé primaire complète, et non d’une partie seulement. Elle supprime ainsi les dépendances partielles et encore plus de doublons.
Troisième forme normale (3NF): la 3NF va un cran plus loin en éliminant les dépendances transitives. Tous les attributs non clés doivent dépendre uniquement de la clé primaire, et non d’autres attributs non clés. On évite ainsi la répétition des données en supprimant les relations implicites entre attributs.
2. Choisir son système de base de données
Pour bien choisir, il faut comparer les performances des bases relationnelles comme PostgreSQL, MySQL et SQL Server avec celles des alternatives NoSQL comme MongoDB et Cassandra. Le choix dépend surtout de la structure de vos données et du type de requêtes que vous exécutez.
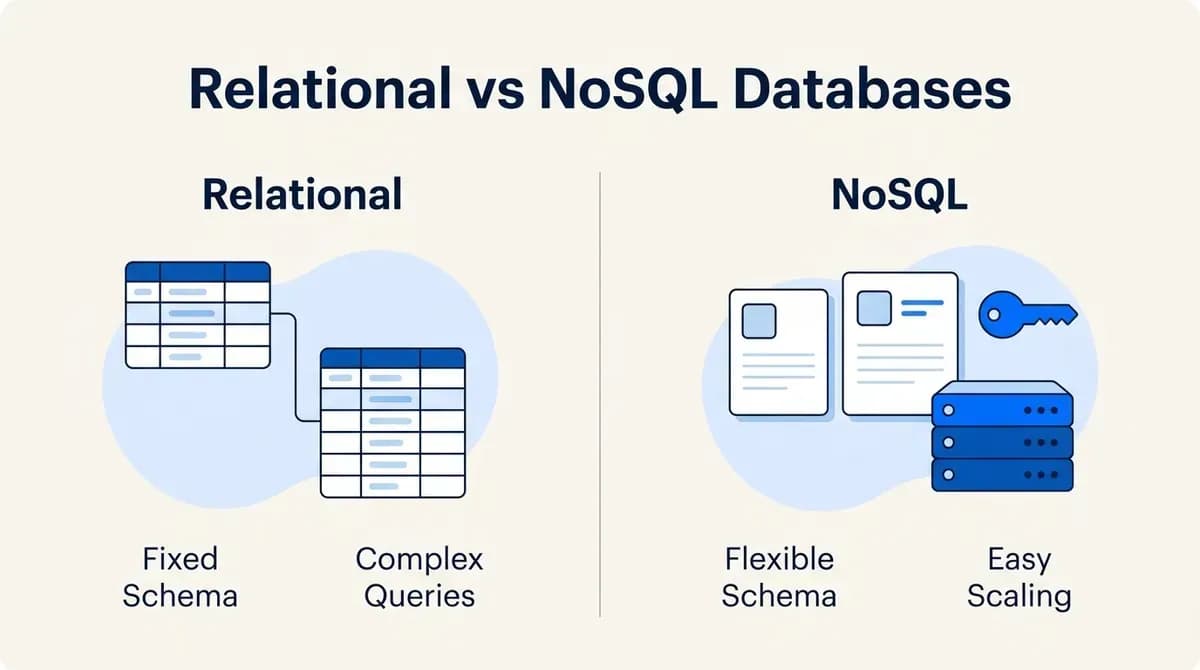
Bases de données relationnelles (PostgreSQL, MySQL et SQL Server)
Données structurées: l’un des grands atouts des bases relationnelles est la gestion de données structurées avec des schémas bien définis. Si vos données sont structurées et que vous devez modéliser de nombreuses relations entre entités, une base relationnelle est le meilleur choix.
Conformité ACID: ACID (atomicité, cohérence, isolation, durabilité) : ces propriétés garantissent l’intégrité des données et la cohérence des transactions. C’est un avantage décisif pour les applications où l’intégrité est critique, comme les systèmes bancaires ou les plateformes e-commerce.
Support de SQL: les bases relationnelles utilisent SQL (Structured Query Language), un langage puissant et universel pour manipuler les données. Si votre équipe maîtrise SQL ou si votre application doit exécuter des requêtes complexes, une base relationnelle est adaptée.
Les options NoSQL (MongoDB, Cassandra)
Schéma flexible: là où les bases relationnelles comme MySQL, Oracle et PostgreSQL imposent une structure fixe avec des schémas prédéfinis, les bases NoSQL comme MongoDB et Cassandra offrent des schémas flexibles, adaptés aux données semi-structurées et non structurées. Cette souplesse est précieuse quand les besoins évoluent souvent ou que les données sont très hétérogènes.
Scalabilité: les bases NoSQL sont conçues pour monter en charge horizontalement, ce qui les rend idéales pour gérer d’énormes volumes de données et des charges de travail intenses. MongoDB et Cassandra sont particulièrement appréciées pour leur architecture distribuée et leur facilité à répartir la charge sur plusieurs nœuds.
Modèles de requêtes: les bases NoSQL sont optimisées pour certains types de requêtes : requêtes sur des documents (MongoDB), sur des colonnes larges (Cassandra) ou recherches clé-valeur (Redis, DynamoDB). Pour les applications dont les données sont stockées sous forme de clé-valeur ou de documents, elles surpassent les bases relationnelles en performance et en scalabilité.
Pour choisir entre relationnel et NoSQL, tenez compte de la nature de vos données, de vos modèles de requêtes et du niveau de scalabilité dont votre système a besoin.
Les bases relationnelles sont faites pour les données structurées et les requêtes complexes, tandis que les bases NoSQL misent sur la flexibilité, la scalabilité et des modèles de requêtes optimisés.
Au final, la décision doit reposer sur les besoins et les contraintes propres à votre projet.
3. Les bases de données distribuées
Dans une architecture de base de données distribuée, les données sont réparties sur plusieurs serveurs ou nœuds au lieu d’être stockées sur un seul serveur. Cette approche est née du besoin de traiter de très gros volumes de données.
Des volumes de données massifs: dans beaucoup de systèmes, et surtout dans les services web de dernière génération, la quantité de données générées et stockées explose. Un tel volume peut dépasser la capacité d’un seul serveur à le stocker, le traiter et le gérer correctement.
Scalabilité: les bases distribuées répondent à ce problème en répartissant la charge entre plusieurs serveurs ou nœuds. Données et traitements sont partagés, ce qui permet de monter en charge horizontalement en ajoutant des serveurs dès que les volumes de données et la demande des utilisateurs augmentent.
Répartition de la charge: les bases distribuées répartissent les données et les traitements entre plusieurs serveurs, ce qui évite qu’un seul d’entre eux devienne un goulot d’étranglement. Chaque serveur porte une partie des données et de la charge, et ensemble ils gèrent efficacement la base et les requêtes des utilisateurs.
Tolérance aux pannes: les bases distribuées offrent souvent de la redondance et une tolérance aux pannes qui garantissent la disponibilité et la fiabilité des données. En cas de panne d’un serveur ou de coupure réseau, le système continue de tourner : les opérations sont redirigées vers les serveurs disponibles et la cohérence des données est préservée.
Comment optimiser une base de données ?
Les méthodes d’optimisation fondamentales constituent la base de tout travail sur la performance. Elles permettent aux entreprises de tirer pleinement parti de leur infrastructure de données.
L’indexation est une solution, le partitionnement en est une autre, et chaque méthode cible des opérations précises pour éliminer les goulots d’étranglement et améliorer les performances.
Nous allons nous concentrer sur les grands principes d’optimisation utilisés dans la gestion des bases de données, et voir ce que chaque méthode apporte à la performance, à la scalabilité et à l’efficacité globale d’une appli.
En maîtrisant ces stratégies, les entreprises peuvent exploiter leurs bases de données pour innover, gagner en agilité et prendre l’avantage dans un environnement piloté par la donnée.
L’indexation
L’indexation est une technique d’optimisation essentielle, qui accélère considérablement l’exécution des requêtes et la récupération des données.
En concevant et en entretenant les index en fonction des modèles de requêtes et des contraintes de performance, les administrateurs de bases de données trouvent le bon équilibre entre les avantages et les inconvénients de l’indexation.
Les avantages d’une bonne indexation
Des requêtes plus rapides: une colonne correctement indexée accélère nettement les requêtes SELECT et raccourcit le temps de récupération pour l’utilisateur.
Moins de parcours complets de tables: grâce aux index, la base accède directement aux lignes utiles sans parcourir toute la table, ce qui accélère la récupération des données.
Une meilleure efficacité: des index bien conçus réduisent les opérations d’accès et de lecture, ce qui rend la base de données plus efficace.
Points d’attention pour l’indexation
Choix des colonnes: bien choisir les colonnes à indexer est crucial. Celles qui apparaissent souvent dans les conditions WHERE, les JOIN et les clauses ORDER BY sont de bonnes candidates.
Modèles de requêtes: identifier les types de requêtes exécutées sur la base, et les colonnes à indexer pour elles, améliore les performances.
Trouver l’équilibre: l’indexation peut accélérer les requêtes, mais multiplier les index est une mauvaise idée : ils coûtent du stockage et ralentissent les écritures. Il ne faut pas sous-estimer la recherche du bon équilibre.
L’optimisation des requêtes
L’optimisation des requêtes consiste à améliorer la performance et l’efficacité des requêtes envoyées à la base. On examine les requêtes et leurs plans d’exécution pour repérer les goulots d’étranglement et les inefficacités, puis on propose et applique des stratégies pour les rendre plus performantes.
Les avantages de l’optimisation des requêtes
De meilleures performances: des requêtes bien optimisées répondent plus vite, ce qui améliore les performances du système et réduit l’attente des utilisateurs.
Une meilleure scalabilité: des requêtes efficaces consomment moins de ressources, si bien que le système peut traiter davantage de requêtes en parallèle sans perte de performance.
Moins de ressources consommées: des requêtes optimisées utilisent moins de cycles CPU, de mémoire et d’I/O disque, ce qui réduit la consommation de ressources et les coûts d’exploitation.
Une meilleure expérience utilisateur: des requêtes plus rapides rendent l’expérience fluide et interactive, et les utilisateurs sont plus satisfaits et plus engagés.
Une latence plus faible: des requêtes précises réduisent la latence en diminuant le temps nécessaire pour obtenir et traiter les données, avec des temps de réponse plus courts pour les utilisateurs et les applications.
Les outils d’optimisation des requêtes
EXPLAIN: génère le plan d’exécution d’une requête en détaillant chaque opération de la base, ce qui permet de localiser les points de congestion et d’améliorer ce plan.
ANALYZE: collecte des statistiques sur l’utilisation des tables et des index, utiles pour observer la distribution des données et les performances des requêtes, et donc pour repérer ce qu’il faut optimiser.
Profileurs de base de données: suivent l’activité de la base, comme les requêtes lentes, les opérations gourmandes en ressources et les goulots d’étranglement, pour cibler les optimisations.
Assistants d’optimisation de requêtes: proposent automatiquement des pistes d’optimisation : meilleurs index, réécriture de requêtes, changements de configuration.
Visualiseurs de plans de requêtes: affichent graphiquement les plans d’exécution pour mettre en évidence les opérations critiques et les endroits à optimiser.
Monter en charge pour accompagner la croissance
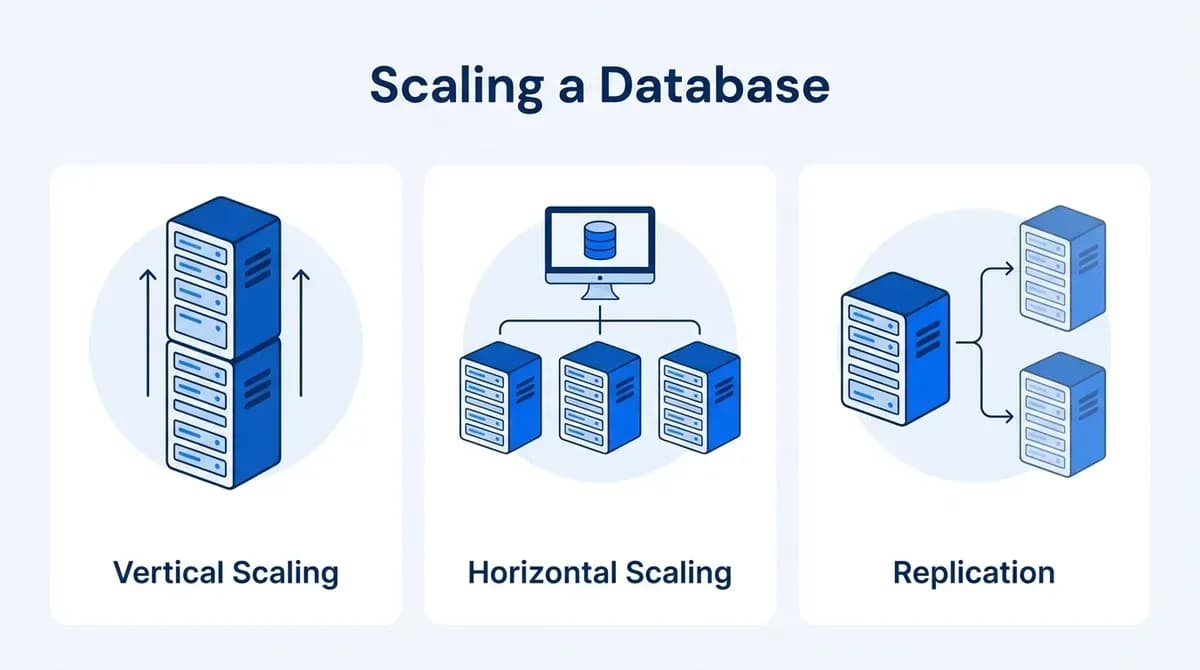
Monter en charge, c’est augmenter la capacité du système à absorber une charge plus importante. Il existe trois grandes approches : la scalabilité verticale, la scalabilité horizontale et la réplication.
Chaque technique a ses avantages et ses inconvénients, que les équipes doivent analyser avec soin pour choisir celle qui correspond à leur infrastructure en croissance.
La scalabilité verticale
Définition: la scalabilité verticale, ou scale-up, consiste à augmenter la capacité d’un serveur en lui ajoutant du CPU, de la mémoire ou du stockage. En pratique, on passe généralement à un serveur plus puissant.
Des limites inhérentes: la scalabilité verticale bute sur des limites physiques, et au-delà d’un certain seuil elle devient coûteuse, voire irréaliste. De plus, un serveur unique reste un point de défaillance unique, avec un risque d’interruption de service et de perte de données.
La scalabilité horizontale (sharding)
Répartition des données: la scalabilité horizontale, ou scale-out, consiste à répartir les données entre plusieurs serveurs ou nœuds. Le sharding en est l’une des méthodes les plus répandues : les données sont partitionnées et chaque morceau est placé sur un shard différent, hébergé sur son propre serveur.
Une complexité réelle: le sharding oblige à gérer la répartition des données, à maintenir leur cohérence entre les shards et à rééquilibrer ceux-ci quand le système grandit. Sa mise en place et sa maintenance demandent une planification et une coordination rigoureuses.
Un meilleur débit: en contrepartie, la scalabilité horizontale répartit la charge sur plusieurs serveurs, si bien que le système peut traiter davantage de requêtes simultanées sans surcharger aucun d’entre eux.
La réplication
Répartir le trafic en lecture: pour garantir de bonnes performances quand les lectures dominent, on crée couramment des réplicas de la base. Les réplicas en lecture absorbent les requêtes de lecture à la place de la base principale, ce qui allège le serveur principal et améliore la scalabilité.
Idéal pour les charges à forte lecture: la réplication permet de répartir horizontalement les lectures entre plusieurs copies. L’application peut ainsi servir beaucoup plus de lectures sans compromettre la cohérence des écritures.
Basculement et haute disponibilité: la réplication assure le basculement et la haute disponibilité en conservant des copies des données à deux endroits différents. Si la base principale tombe, le réplica prend le relais et continue de servir les requêtes, ce qui limite l’interruption et maintient le service.
Pour aller plus loin
Voyons maintenant des techniques plus avancées pour optimiser les bases de données.
Le cache
Le rôle du cache en mémoire: les solutions de cache en mémoire comme Memcached et Redis accélèrent la récupération des données en stockant les données les plus consultées et le résultat des lectures en base.
Bonnes pratiques: il s’agit d’identifier les données chaudes, de définir des durées d’expiration adaptées et de mettre en place des mécanismes d’invalidation du cache, afin de garantir la cohérence des données et de maximiser le taux de succès du cache.
La compression des données
Usage et avantages: la compression soulage les I/O disque en stockant les données dans un format compressé, qui économise de l’espace et accélère les transferts. Elle est intéressante pour les gros jeux de données répétitifs, où le gain dépasse le surcoût de traitement.
Les compromis possibles: si la compression fait gagner en stockage et en I/O, elle ajoute une charge CPU lors de la compression et de la décompression. Bien gérer les ressources CPU et les accès aux données permet de limiter ces compromis.
Le partitionnement des données
Gagner en efficacité: le partitionnement découpe une grande table en unités logiques selon certains critères, comme des plages de valeurs ou des fonctions de hachage. Répartir les données sur plusieurs supports ou serveurs permet le traitement en parallèle et réduit la contention, ce qui améliore l’efficacité globale.
Une mise en œuvre optimale: un bon partitionnement tient compte des modèles de requêtes, de la fréquence d’accès et du coût de maintenance pour obtenir une répartition équilibrée et des requêtes performantes.
Déporter l’analytique
Bases séparées ou entrepôts de données: déplacer l’analytique vers des bases analytiques ou des entrepôts de données distincts des bases transactionnelles sépare les deux types de charge, supprime la concurrence pour les ressources et garantit des performances stables pour chacune.
Avantages: ces environnements analytiques dédiés s’appuient sur du matériel et des logiciels optimisés pour le reporting et l’analyse complexes sur de grands volumes, sans jamais perturber les systèmes transactionnels.
Les options modernes pour les applis à fort trafic
Les fondamentaux ci-dessus restent valables, mais les services managés actuels déchargent votre équipe d’une bonne partie du travail :
- Postgres serverless (Neon, Amazon Aurora Serverless) : la puissance de calcul suit le trafic à la hausse comme à la baisse, vous payez moins aux heures creuses et vous absorbez quand même les pics.
- SQL distribué (CockroachDB, Google Spanner) : des tables relationnelles et du SQL, avec des données réparties sur plusieurs régions pour la scalabilité et la résilience.
- Pooling de connexions (PgBouncer, RDS Proxy) : les applis mobiles ouvrent beaucoup de connexions courtes, et un pooler les empêche de submerger la base lors des pics.
- Caches managés (services compatibles Redis comme Valkey et Amazon ElastiCache) : du cache en mémoire sans avoir à gérer vos propres serveurs de cache.
Indicateurs de performance et monitoring
Le suivi des indicateurs et le monitoring sont des processus continus, qui maintiennent la base de données en phase avec l’évolution des besoins métier et des attentes de performance.
Les indicateurs clés
Débit: le nombre de transactions ou de requêtes traitées par unité de temps, qui reflète la capacité de traitement de la base.
Latence: le temps nécessaire à l’exécution d’une requête ou d’une transaction, qui dépend notamment de la réactivité de la base.
Concurrence: le nombre d’opérations ou de requêtes simultanées qu’une base peut traiter par unité de temps sans perdre en vitesse.
Utilisation des ressources: le suivi du CPU, de la mémoire, des I/O disque et du réseau pour repérer les saturations et optimiser l’allocation des ressources.
Les outils de monitoring des performances
Outils des systèmes de gestion de bases de données (DBMS): la plupart des DBMS fournissent des outils de monitoring ou des consoles d’administration qui collectent en temps réel les indicateurs de performance de la base.
Solutions de monitoring tierces: des outils tiers de monitoring des bases de données offrent des analyses avancées, des systèmes d’alerte et des tableaux de bord personnalisables.
Pourquoi le monitoring est indispensable
Détection précoce des problèmes: le monitoring permet de repérer les requêtes lentes, les saturations de ressources ou les erreurs de configuration avant qu’elles ne provoquent des pannes critiques.
Pistes d’optimisation: en étudiant les indicateurs, les administrateurs identifient ce qu’il faut optimiser, ajustent les configurations et appliquent les bonnes pratiques pour rendre la base plus efficace.
Planification des capacités: suivre les indicateurs dans le temps permet de planifier les capacités et d’anticiper les besoins en ressources pour faire évoluer l’infrastructure de manière proactive.
Les bonnes pratiques de monitoring
Fixer des objectifs clairs: définissez des objectifs et des indicateurs de performance adaptés aux ressources nécessaires et aux attentes des utilisateurs de l’application.
Surveiller régulièrement: suivez les indicateurs en temps réel et conservez un historique pour repérer les tendances, les anomalies et les dégradations de performance.
Alertes et notifications: mettez en place des alertes qui préviennent les responsables en cas d’incident critique ou de valeurs qui s’écartent de la normale.
Analyse des causes profondes: quand un problème de performance survient, menez une analyse complète pour identifier ce qui l’a rendu possible et mettez en place les actions correctives.
L’optimisation de base de données, un cycle d’itérations sans fin
L’optimisation itérative est une démarche méthodique qui améliore l’efficacité et la productivité d’un système en répétant un même cycle. Elle favorise l’apprentissage continu et l’adaptation aux retours et aux indicateurs, ce qui produit des progrès successifs.
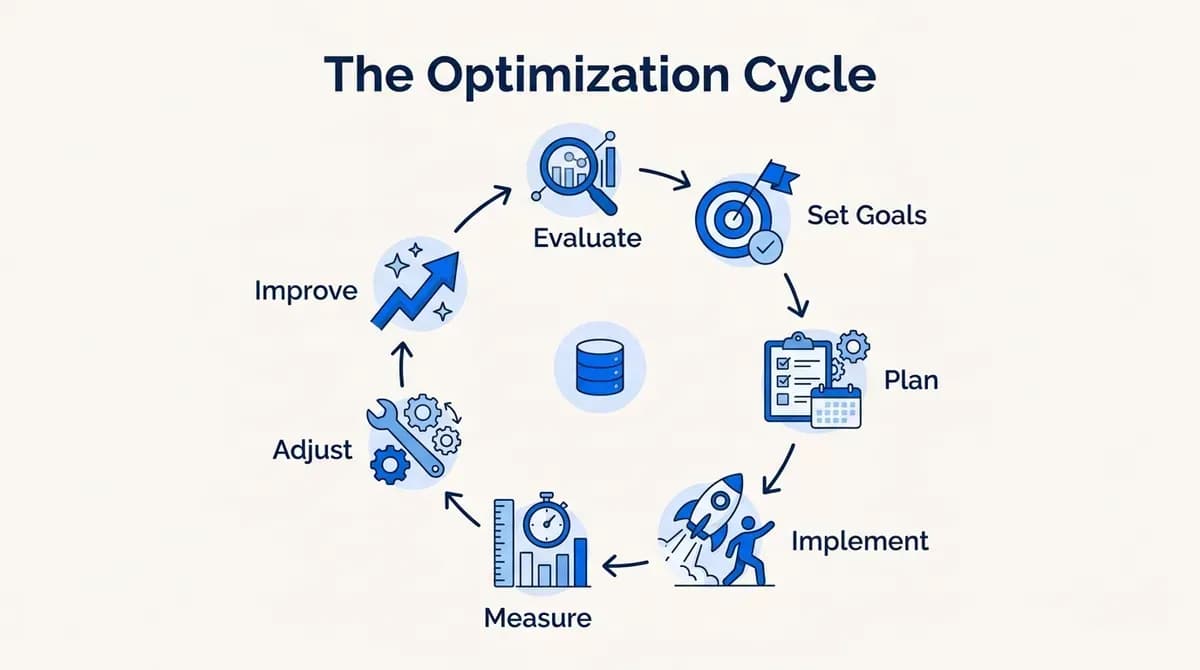
1. Évaluation et analyse
Évaluer les performances actuelles: mesurez les performances du système en analysant les indicateurs, les goulots d’étranglement et ses limites.
Recueillir des retours: sollicitez les utilisateurs, les développeurs et les parties prenantes pour connaître leurs difficultés, leurs attentes en matière de performance et les points à améliorer.
2. Objectifs et priorités
Définir les objectifs d’optimisation: fixez des objectifs et des indicateurs de performance à partir des résultats de l’évaluation et des retours reçus.
Prioriser les efforts: identifiez les principaux problèmes de performance et classez les chantiers selon leur impact sur l’expérience utilisateur, la stabilité du système et les objectifs métier.
3. Élaboration de la stratégie
Identifier les stratégies d’optimisation: recherchez les méthodes, techniques et bonnes pratiques qui permettent de résoudre ces problèmes de performance.
Adapter les stratégies aux objectifs: ajustez les stratégies d’optimisation aux objectifs fixés, aux priorités et aux caractéristiques de votre système de base de données.
4. Mise en œuvre et tests
Exécuter le plan d’optimisation: appliquez les techniques d’optimisation, les modifications et les réglages de performance dans l’environnement de la base.
Tests et validation: vérifiez rigoureusement que les optimisations apportent bien les gains de performance et d’efficacité attendus.
5. Suivi et mesure
Suivre les indicateurs de performance: mesurez l’impact des optimisations en surveillant les indicateurs clés de la base après leur mise en place.
Mesurer les résultats: évaluez le succès de l’optimisation en comparant les résultats aux objectifs et aux indicateurs fixés, en relevant ce qui fonctionne et ce qui reste à améliorer.
6. Retours et ajustements
Recueillir des retours: interrogez les utilisateurs, les développeurs et les administrateurs système, principales parties prenantes, sur l’effet de l’optimisation sur les performances et l’expérience utilisateur.
Ajustements itératifs: à partir des retours et du monitoring, corrigez progressivement les stratégies et les configurations pour affiner le fonctionnement de la base et résoudre les problèmes restants.
7. Amélioration continue
Un cycle itératif: l’optimisation est un processus continu d’évaluation, de mise en œuvre, de tests et d’ajustements.
Apprentissage continu: capitalisez sur ce que vous apprenez à chaque étape et documentez-le pour améliorer les performances à chaque nouvelle phase d’optimisation.
Conclusion
Optimiser la base de données d’une application mobile à fort trafic, c’est viser la satisfaction des utilisateurs et des performances durables. L’indexation stratégique, l’optimisation des requêtes complexes, le cache et la compression des données aident la base à traiter rapidement de gros volumes.
Les techniques de montée en charge comme le sharding (horizontal) renforcent la scalabilité, et le monitoring en temps réel permet d’optimiser les performances en continu. L’optimisation et l’amélioration itérative deviennent alors possibles, même face aux exigences d’un trafic mobile élevé.
Au final, c’est une base de données bien conçue qui permet à une appli mobile de continuer à grandir sans ralentir. Une application mobile sur mesure signée Appkodes, avec une base de données pensée pour le fort trafic dès la première version, démarre à $8,000, avec un plan chiffré à prix fixe avant le début des travaux, et la plupart des premières versions sont en ligne en 30 jours environ.
Questions fréquentes
Qu’est-ce que l’optimisation de base de données ?
C’est améliorer la façon dont une base stocke et récupère les données, via le schéma, les index, l’optimisation des requêtes, le cache et la montée en charge, pour que l’appli reste rapide quand les utilisateurs et les données augmentent.
Une application mobile doit-elle utiliser SQL ou NoSQL ?
Les bases SQL comme PostgreSQL conviennent aux données structurées et aux transactions ; les bases NoSQL comme MongoDB, aux données flexibles ou très volumineuses. Beaucoup d’applis utilisent les deux.
Quel est le moyen le plus rapide d’accélérer une base de données lente ?
Repérez les requêtes les plus lentes avec EXPLAIN et le journal des requêtes lentes, ajoutez les bons index et mettez en cache les données souvent lues dans Redis ou un équivalent.
Quand faut-il faire du sharding sur sa base de données ?
Seulement quand un seul serveur ne suffit plus pour vos écritures ou votre volume de données. Essayez d’abord les index, le cache, les réplicas en lecture et un serveur plus puissant, car le sharding ajoute de la complexité.
Combien coûte le développement d’une application à fort trafic ?
Cela dépend des fonctionnalités et de la charge attendue. Une application sur mesure signée Appkodes, avec une base de données conçue pour monter en charge, démarre à $8,000, et la plupart des premières versions sont en ligne en 30 jours environ.

Arun Andiselvam
LinkedInJe suis un entrepreneur qui a créé cinq marques. J'ai revendu la première, un outil SEO, pour un montant à six chiffres, et je dirige aujourd'hui Appkodes, qui conçoit des applications mobiles et web sur mesure pour les fondateurs et les entreprises. J'ai financé chacune d'elles moi-même dès le premier jour.