Bienvenido al mundo de las aplicaciones móviles, donde soportar mucho tráfico y enormes volúmenes de datos es tan difícil como hacer malabares con una docena de pelotas a la vez.
La complejidad de mantener las apps funcionando también aumenta, sobre todo en apps sociales, de streaming o marketplaces con una gran base de usuarios, como sabe cualquier empresa de desarrollo de apps móviles con experiencia. A los usuarios también les preocupa cómo proteger las apps móviles y mejorar su experiencia con la app.
Optimizar la base de datos resuelve eso. Le da a tu software un impulso de rendimiento y escala que mejora la experiencia del usuario. Además, responde a tu pregunta sobre cómo mejorar el rendimiento de una app móvil.
Ahora entramos en la parte central de esta guía: la optimización de bases de datos en apps móviles populares. Veremos los problemas de los grandes volúmenes de datos, cómo ejecutar consultas más rápido y cómo eliminar los molestos cuellos de botella que puedan aparecer.
Es hora de lanzar tu app al mundo y ver a los usuarios recorrer tu universo digital con una gran sonrisa.
Pilares fundamentales de la optimización de bases de datos
La optimización de bases de datos se apoya en varios pilares, todos igual de importantes para el rendimiento, la escalabilidad y la eficiencia. Estos son los principales.
1. Normalización
La normalización consiste en organizar los datos en tablas con sentido y eliminar la duplicación.
Su objetivo principal es evitar la redundancia y eliminar dependencias; así mejora la integridad de los datos y se reduce el riesgo de anomalías al manipularlos.
Primera forma normal (1NF): las columnas de una tabla en 1NF deben contener valores atómicos que no se puedan dividir. Además, cada columna debe ser distinta y cada fila, única. Esto descarta guardar varios valores en una sola celda y da como resultado datos en formato tabular.
Segunda forma normal (2NF): la 2NF amplía la 1NF al asegurar que todos los atributos que no son clave dependan funcionalmente de la clave primaria completa. Es decir, cada atributo no clave depende de toda la clave primaria y no solo de una parte. Así se eliminan las dependencias parciales y aún más duplicados de los mismos datos.
Tercera forma normal (3NF): la 3NF es un paso más en la normalización para eliminar las dependencias transitivas. Significa que todos los atributos no clave deben depender solo de la clave primaria y no de otros atributos no clave. Esto ayuda a eliminar la repetición de datos al quitar las relaciones implícitas entre atributos.
2. Elegir el sistema de base de datos
Para elegir bien la base de datos, es clave comparar el rendimiento de las bases relacionales como PostgreSQL, MySQL y SQL Server con alternativas NoSQL como MongoDB y Cassandra. La decisión depende sobre todo de la estructura de tus datos y del tipo de consultas que hagas.
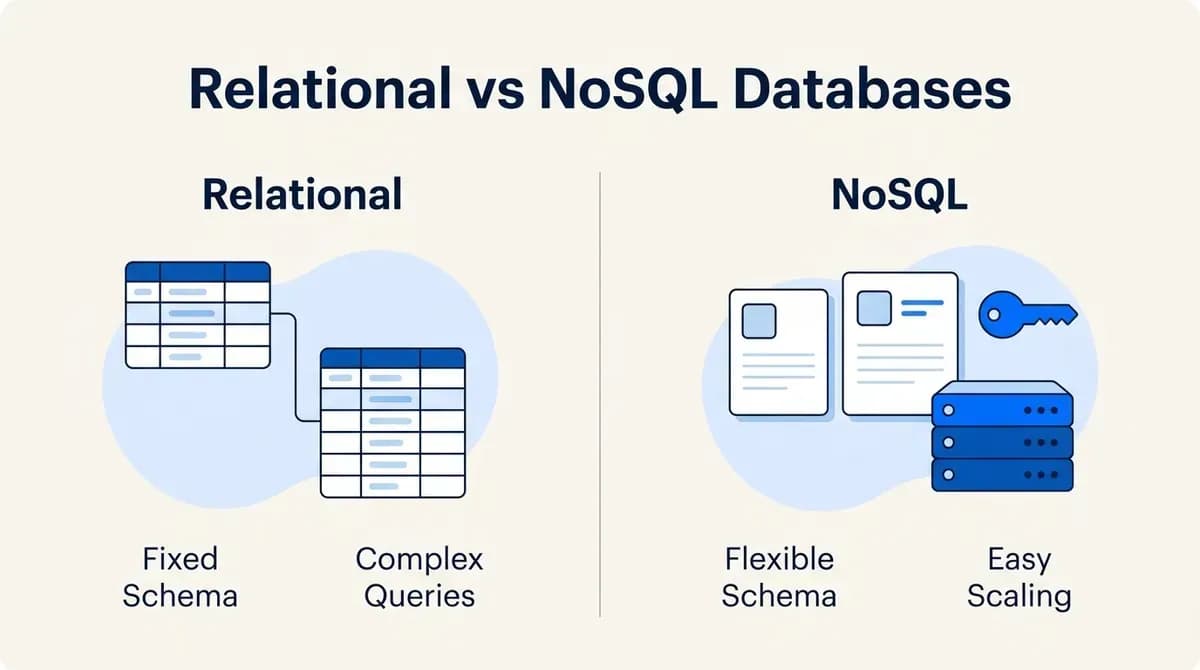
Bases de datos relacionales (PostgreSQL, MySQL y SQL Server)
Datos estructurados: una de las grandes ventajas de las bases relacionales es que manejan datos estructurados con esquemas bien definidos. Si tus datos son estructurados y necesitas muchas relaciones entre entidades, las bases relacionales son la mejor opción.
Cumplimiento ACID: las propiedades ACID (atomicidad, consistencia, aislamiento y durabilidad) que garantizan estos sistemas aseguran la integridad de los datos y la consistencia de las transacciones. Eso les da ventaja en aplicaciones donde la integridad es vital, como la banca o el comercio electrónico.
Soporte de SQL: las bases relacionales usan SQL (Structured Query Language), un lenguaje potente y universal para trabajar con datos. Si tu equipo conoce SQL o tu aplicación necesita consultas complejas, las bases relacionales son una buena elección.
Opciones NoSQL (MongoDB, Cassandra)
Esquema flexible: mientras que las bases relacionales como MySQL, Oracle y PostgreSQL tienen una estructura fija con esquemas predefinidos, las bases NoSQL como MongoDB y Cassandra ofrecen esquemas flexibles para trabajar con datos semiestructurados y no estructurados. Esa flexibilidad es muy útil cuando los requisitos cambian o los datos son muy variados.
Escalabilidad: las bases NoSQL están diseñadas para escalar horizontalmente, por lo que son ideales para manejar grandes cantidades de datos y cargas de trabajo de alto volumen. MongoDB y Cassandra son especialmente populares por su arquitectura distribuida y su facilidad para escalar entre nodos.
Patrones de consulta: las bases NoSQL están optimizadas para estilos de consulta concretos, por ejemplo, consultas de documentos (MongoDB), de columnas anchas (Cassandra) y búsquedas clave-valor (Redis, DynamoDB). En aplicaciones donde los datos se guardan como clave-valor o como documentos, las NoSQL superan a las relacionales en rendimiento y escalabilidad.
Al elegir entre bases relacionales y NoSQL, piensa en cómo son tus datos, cuál es tu patrón de consultas y cuánto necesita escalar tu sistema.
Las bases relacionales están pensadas para datos estructurados y consultas complejas, mientras que las NoSQL ofrecen flexibilidad, escalabilidad y patrones de consulta optimizados.
Al final, la decisión depende de las necesidades y limitaciones concretas de tu proyecto.
3. Bases de datos distribuidas
Se trata de una arquitectura en la que los datos se reparten entre varios servidores o nodos, en lugar de guardarse en uno solo. Este enfoque surgió para manejar volúmenes de datos muy grandes.
Volúmenes masivos de datos: en muchos sistemas, sobre todo en los servicios web más recientes, la cantidad de datos generados y almacenados crece de forma notable. Un volumen así puede superar la capacidad de un servidor para almacenarlo, procesarlo y gestionarlo bien.
Escalabilidad: las bases de datos distribuidas resuelven el manejo de grandes volúmenes repartiendo la carga entre varios servidores o nodos. Al compartir los datos y el procesamiento, el sistema puede escalar horizontalmente, agregando servidores cuando hace falta para atender más datos y más usuarios.
Distribución de la carga: las bases distribuidas reparten los datos y las tareas de procesamiento entre varios servidores, lo que evita que uno solo se convierta en un cuello de botella. Cada servidor tiene una parte de los datos y del trabajo, y entre todos gestionan de forma eficaz los datos y las solicitudes de los usuarios.
Tolerancia a fallos: las bases distribuidas suelen ofrecer redundancia y tolerancia a fallos para garantizar la disponibilidad y la confiabilidad de los datos. Si un servidor falla o se corta la red, el sistema sigue funcionando porque las operaciones se redirigen a los servidores disponibles, y la consistencia de los datos se mantiene.
¿Cómo optimizar una base de datos?
Los métodos fundamentales de optimización son la base de todo el trabajo. Ayudan a las empresas a aprovechar al máximo su infraestructura de datos.
Una solución es la indexación, otra es el particionamiento, y cada método atiende operaciones distintas para eliminar cuellos de botella y mejorar el rendimiento.
Aquí nos centraremos en los principios clave de optimización que se usan en la gestión de bases de datos, y veremos cómo cada método mejora el rendimiento, la escalabilidad y la eficacia general de una app.
Si dominan estas estrategias, las empresas pueden usar sus bases de datos para impulsar la innovación, la agilidad y la ventaja competitiva en un entorno cada vez más basado en datos.
Indexación
La indexación es una técnica de optimización muy importante que mejora enormemente el rendimiento de las consultas y la recuperación de datos.
Si diseñan y mantienen bien los índices según los patrones de consulta y las necesidades de rendimiento, los administradores de bases de datos pueden equilibrar las ventajas y desventajas de indexar.
Beneficios de una buena indexación
Consultas más rápidas: una columna bien indexada hace que las consultas SELECT se ejecuten mucho más rápido y acorta la espera del usuario.
Menos escaneos completos de tabla: gracias a los índices, la base de datos accede rápido a las filas necesarias sin recorrer toda la tabla, así que la recuperación de datos es más veloz.
Mayor eficiencia: los índices bien diseñados reducen las operaciones de acceso y recuperación de datos, lo que aumenta la eficiencia de la base de datos.
Aspectos a considerar al indexar
Elección de columnas: decidir qué columnas indexar es importante. Las que aparecen a menudo en condiciones WHERE, JOIN y cláusulas ORDER BY son buenas candidatas.
Patrones de consulta: identificar qué tipos de consultas se ejecutan en la base de datos y qué columnas indexar para ellas mejora el rendimiento.
Encontrar el equilibrio: los índices pueden acelerar las consultas, pero agregar demasiados no es buena idea, porque aumentan el almacenamiento y hacen más lentas las escrituras. No hay que subestimar la importancia de encontrar el punto justo.
Optimización de consultas
La optimización de consultas busca mejorar el rendimiento y la eficiencia de las consultas a la base de datos. Consiste en examinar las consultas y sus planes de ejecución para detectar cuellos de botella e ineficiencias, y luego proponer y aplicar estrategias que mejoren su rendimiento.
Beneficios de optimizar las consultas
Mejor rendimiento: las consultas bien optimizadas responden en menos tiempo, lo que mejora el rendimiento del sistema y reduce la espera de los usuarios.
Mayor escalabilidad: las consultas eficientes consumen menos recursos, así que el sistema puede atender más solicitudes en paralelo sin perder rendimiento.
Menor consumo de recursos: las consultas ajustadas usan menos ciclos de CPU, memoria e I/O de disco, lo que reduce el uso de recursos y los costos operativos.
Mejor experiencia de usuario: las consultas más rápidas ofrecen una experiencia fluida e interactiva, con usuarios más satisfechos y comprometidos.
Menor latencia: las consultas precisas reducen la latencia porque acortan el tiempo para obtener y procesar los datos, y dan respuestas más rápidas a usuarios y aplicaciones.
Herramientas para optimizar consultas
EXPLAIN: genera el plan de ejecución de una consulta con el detalle de las operaciones de la base de datos, lo que permite localizar cuellos de botella y mejorar ese plan.
ANALYZE: recopila estadísticas sobre el uso de tablas e índices que ayudan a ver la distribución de los datos y el rendimiento de las consultas, y así detectar qué se puede optimizar.
Profilers de bases de datos: registran la actividad de la base de datos, como consultas lentas, operaciones que consumen muchos recursos y cuellos de botella, para ajustar las optimizaciones.
Asistentes de ajuste de consultas: dan recomendaciones automáticas para optimizar consultas mediante mejoras en los índices, reescritura de consultas y cambios de configuración.
Visualizadores de planes de consulta: muestran de forma gráfica los planes de ejecución para destacar las operaciones críticas para el rendimiento y dónde optimizar.
Escalar para crecer
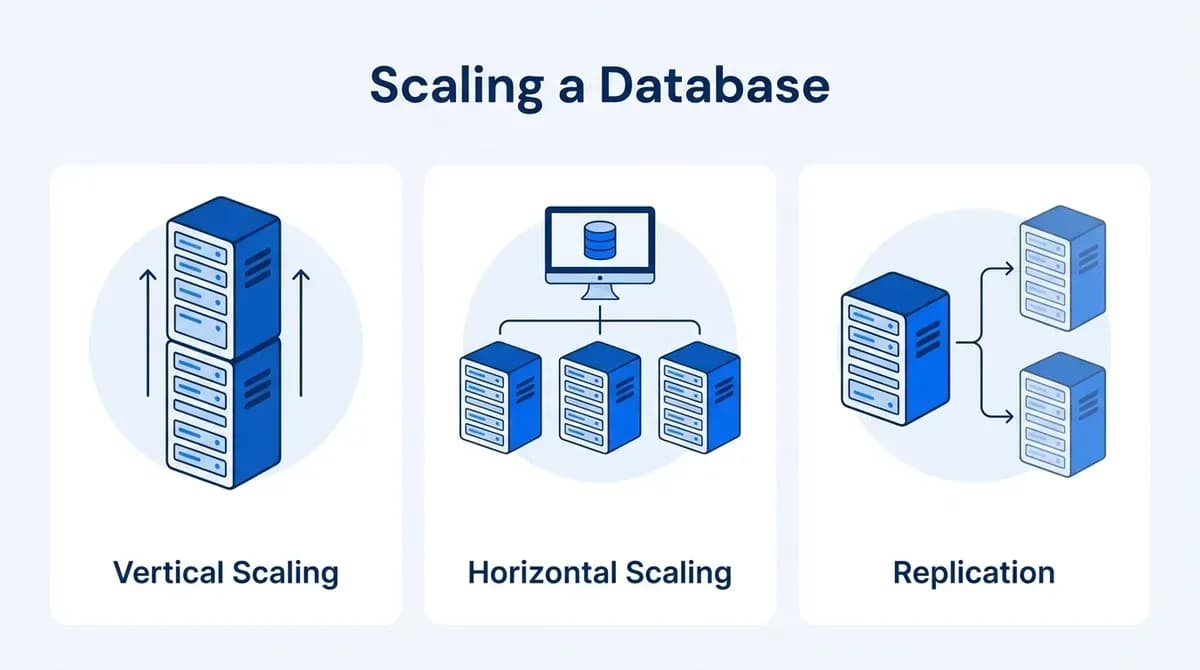
Escalar para crecer significa ampliar la capacidad del sistema para soportar más carga. Se puede hacer de tres formas: escalado vertical, escalado horizontal y replicación.
Cada técnica tiene ventajas y desventajas que las empresas deben analizar con cuidado para elegir la que mejor se adapte a su infraestructura en crecimiento.
Escalado vertical
Qué es: el escalado vertical, también llamado scale up, consiste en aumentar la capacidad de un servidor agregando más CPU, memoria o almacenamiento. Por lo general, significa pasar a un servidor más potente.
Limitaciones propias: el escalado vertical tiene problemas de fondo; llega un punto en que no se puede crecer más o resulta caro o poco razonable. Además, un solo servidor es un punto único de falla, lo que puede provocar caídas y pérdida de datos.
Escalado horizontal (sharding)
Distribución de datos: el escalado horizontal, o scale out, consiste en repartir los datos entre varios servidores o nodos. El sharding es uno de los métodos más comunes: los datos se particionan y cada parte se coloca en un shard distinto, alojado en un servidor separado.
Complejidad: el sharding obliga a gestionar la distribución de los datos, mantener la consistencia entre shards y rebalancearlos cuando el sistema crece. Implementarlo y mantenerlo también exige una planificación y coordinación minuciosas.
Mayor throughput: por otro lado, el escalado horizontal reparte la carga entre varios servidores, de modo que el sistema puede atender más solicitudes simultáneas sin sobrecargar ninguno.
Replicación
Distribución del tráfico de lectura: para asegurar un alto rendimiento cuando hay muchas lecturas, se suele usar la replicación para crear réplicas de la base de datos. Las réplicas de lectura absorben las consultas de lectura de la base principal, reducen la carga del servidor primario y ayudan a escalar.
Ventajas con muchas lecturas: la replicación permite escalar las lecturas horizontalmente entre varias copias. Así la aplicación puede atender muchas más lecturas sin afectar la consistencia de las escrituras.
Failover y alta disponibilidad: la replicación permite el failover y la alta disponibilidad al mantener copias de los datos en dos ubicaciones distintas. Si la base de datos principal falla, la réplica pasa a ser la principal y sigue dando servicio, con lo que se minimiza el tiempo de inactividad y el servicio no se interrumpe.
Aspectos avanzados
A continuación veremos funciones más avanzadas e innovadoras para optimizar las bases de datos.
Caché
El papel de la caché en memoria: las soluciones de caché en memoria como Memcached y Redis permiten recuperar datos muy rápido, porque guardan los datos que se consultan con frecuencia y los resultados de las búsquedas en la base de datos.
Buenas prácticas: se trata de identificar los datos más consultados, definir políticas de expiración adecuadas y poner en marcha mecanismos de invalidación de caché que garanticen la consistencia de los datos y logren la mayor tasa de aciertos posible.
Compresión de datos
Uso y beneficios: la compresión alivia la carga de I/O de disco, ya que guardar los datos comprimidos ahorra espacio y acelera la transferencia. Conviene en conjuntos de datos grandes y repetitivos, donde el ahorro compensa el procesamiento extra.
Posibles desventajas: aunque la compresión trae ventajas de almacenamiento e I/O, puede sumar carga de CPU al comprimir y descomprimir. Gestionar bien los recursos de CPU y el acceso a los datos ayuda a evitar esos inconvenientes.
Particionamiento de datos
Más eficiencia: el particionamiento divide una tabla grande en unidades lógicas según ciertos criterios, como rangos o funciones hash. La eficiencia general mejora porque los datos se reparten entre varios dispositivos de almacenamiento o servidores, se procesan en paralelo y se reduce la contención.
Implementación óptima: las buenas estrategias de particionamiento tienen en cuenta los patrones de consulta, la frecuencia de acceso y el costo de mantenimiento para lograr una distribución equilibrada de los datos y consultas optimizadas.
Separar la analítica
Bases de datos o data warehouses aparte: llevar la analítica a bases de datos analíticas o data warehouses independientes de las transaccionales separa ambas cargas de trabajo, elimina la competencia por los recursos y, en consecuencia, garantiza un rendimiento estable para las dos.
Beneficios: los entornos analíticos dedicados cuentan con hardware y software optimizados para reportes y análisis complejos sobre grandes volúmenes de datos, sin provocar caídas en los sistemas transaccionales.
Opciones modernas de bases de datos para apps con mucho tráfico
Lo básico sigue vigente, pero los servicios administrados de hoy le quitan a tu equipo buena parte del trabajo pesado:
- Postgres serverless (Neon, Amazon Aurora Serverless): la base de datos ajusta su capacidad de cómputo según el tráfico, así que pagas menos en los momentos tranquilos y aun así soportas los picos.
- SQL distribuido (CockroachDB, Google Spanner): tablas relacionales y SQL, con los datos repartidos entre regiones para ganar escala y resiliencia.
- Pooling de conexiones (PgBouncer, RDS Proxy): las apps móviles abren muchas conexiones cortas, y un pooler evita que saturen la base de datos durante los picos.
- Cachés administradas (servicios compatibles con Redis como Valkey y Amazon ElastiCache): caché en memoria sin tener que operar tus propios servidores de caché.
Métricas de rendimiento y monitoreo
Las métricas de rendimiento y el monitoreo son procesos continuos que mantienen la base de datos alineada con las necesidades cambiantes del negocio y las expectativas de rendimiento.
Métricas clave de rendimiento
Throughput: mide la cantidad de transacciones o consultas procesadas por unidad de tiempo, es decir, la capacidad de procesamiento de la base de datos.
Latencia: es el tiempo que tarda en ejecutarse una consulta o transacción, que depende de la respuesta de la base de datos.
Concurrencia: representa la cantidad de operaciones o consultas simultáneas que una base de datos puede procesar por unidad de tiempo sin perder velocidad.
Uso de recursos: sigue el uso de CPU, memoria, I/O de disco y red para detectar saturación de recursos y optimizar su asignación.
Herramientas de monitoreo de rendimiento
Herramientas del sistema de gestión de bases de datos (DBMS): la mayoría de los sistemas de gestión de bases de datos incluyen herramientas de monitoreo o consolas de administración que permiten recopilar métricas de rendimiento reales en tiempo real.
Soluciones de monitoreo de terceros: las herramientas de monitoreo de terceros ofrecen analítica avanzada, sistemas de alertas y dashboards personalizables.
Por qué importa el monitoreo
Detección temprana de problemas: el monitoreo permite detectar consultas lentas, saturación de recursos o problemas de configuración antes de que se conviertan en fallas críticas.
Oportunidades de optimización: al estudiar las métricas, los administradores descubren oportunidades para optimizar, ajustar configuraciones y aplicar buenas prácticas que aumentan la eficiencia de la base de datos.
Planificación de capacidad: seguir las métricas a lo largo del tiempo permite planificar la capacidad y anticipar las necesidades futuras de recursos para escalar la infraestructura de forma proactiva.
Buenas prácticas de monitoreo
Define objetivos claros: establece metas y métricas de rendimiento acordes con los recursos necesarios y con lo que esperan los usuarios de la aplicación.
Monitoreo constante: monitorea las métricas en tiempo real y guarda datos históricos para identificar tendencias, anomalías y caídas de rendimiento.
Alertas y notificaciones: configura alertas que avisen a los responsables de incidentes críticos o de valores que se salen de lo normal.
Análisis de causa raíz: cuando surjan problemas de rendimiento, haz un análisis completo de la causa raíz para encontrar qué los originó y tomar medidas para resolverlos.
La optimización de bases de datos como un ciclo de mejora sin fin
El proceso iterativo de optimización es una forma sistemática de mejorar la eficiencia, la eficacia y la productividad de un sistema o proceso mediante ciclos repetidos. Este enfoque favorece el aprendizaje continuo y la adaptación a la retroalimentación y a las métricas, lo que al final se traduce en mejoras graduales y avances.
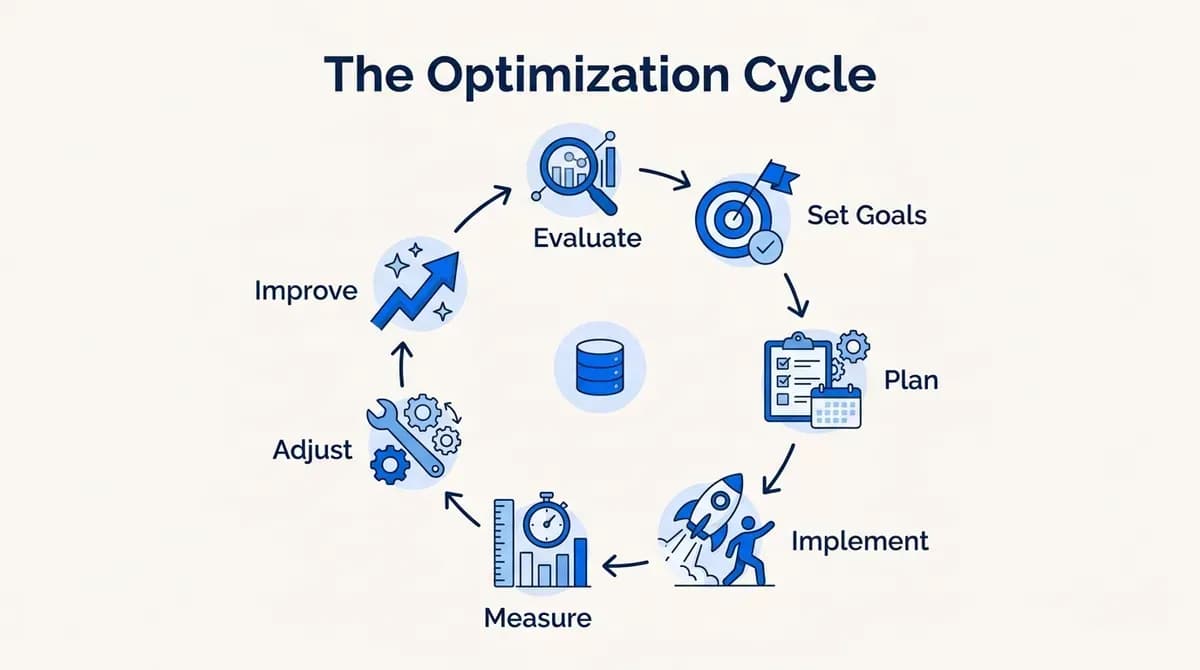
1. Evaluación y análisis
Evalúa el rendimiento actual: analiza las métricas, los cuellos de botella y los límites del sistema para saber cómo rinde.
Recoge retroalimentación: pide opiniones a usuarios, desarrolladores y demás interesados para saber qué les complica, qué rendimiento esperan y qué se debería mejorar.
2. Definir metas y prioridades
Define los objetivos de optimización: establece objetivos e indicadores de rendimiento que reflejen los resultados de la evaluación y las sugerencias recibidas.
Prioriza los esfuerzos: identifica los principales problemas de rendimiento y ordena el trabajo según su impacto en la experiencia del usuario, la estabilidad del sistema y los objetivos del negocio.
3. Desarrollo de la estrategia
Identifica estrategias de optimización: investiga y plantea métodos, técnicas y buenas prácticas para resolver esos problemas de rendimiento.
Adapta las estrategias a las metas: ajusta las estrategias a los objetivos definidos, a las prioridades y a las características del sistema de base de datos.
4. Implementación y pruebas
Ejecuta los planes de optimización: aplica las técnicas de optimización, los cambios y los ajustes de rendimiento en el entorno de la base de datos.
Pruebas y validación: prueba y valida con rigor hasta qué punto las optimizaciones aplicadas lograron las mejoras esperadas en rendimiento y eficiencia operativa.
5. Monitoreo y medición
Monitorea las métricas de rendimiento: después de aplicar las optimizaciones, sigue las métricas e indicadores clave para conocer su impacto en el rendimiento de la base de datos.
Mide los resultados: compara los resultados con las metas y los parámetros de rendimiento definidos para medir el éxito de la optimización y ver qué funciona y qué no.
6. Retroalimentación y ajuste
Recoge retroalimentación: reúne las opiniones de usuarios, desarrolladores y administradores de sistemas, los principales interesados, sobre el efecto de la optimización en el rendimiento y la experiencia del usuario.
Ajuste iterativo: con base en la retroalimentación y el monitoreo, aplica correcciones sucesivas a las estrategias y configuraciones para afinar el funcionamiento de la base de datos y resolver los problemas que queden.
7. Mejora continua
Ciclo iterativo: la optimización es un proceso continuo de evaluación, implementación, pruebas y ajuste.
Aprendizaje continuo: aplica lo aprendido en cada etapa de la optimización y documenta las lecciones para mejorar el rendimiento en cada fase.
Conclusión
En resumen, optimizar la base de datos de una app móvil con mucho tráfico apunta a la satisfacción de los usuarios y a un rendimiento sostenible. La indexación estratégica, la optimización de consultas complejas, la caché y la compresión de datos ayudan mucho a que la base de datos procese grandes volúmenes de información con rapidez.
Técnicas de escalado como el sharding (horizontal) aportan escalabilidad, y el monitoreo en tiempo real permite optimizar el rendimiento de forma continua. Así, la optimización y la mejora iterativa de la base de datos hacen posible atender las exigencias de una app móvil con mucho tráfico.
Al final, una base de datos bien diseñada es lo que permite que una app móvil siga creciendo sin volverse lenta. Una app móvil a medida de Appkodes, con su base de datos diseñada para mucho tráfico desde la primera versión, cuesta desde $8,000, con un plan presupuestado a precio fijo antes de empezar, y la mayoría de las primeras versiones salen en vivo en unos 30 días.
Preguntas frecuentes
¿Qué es la optimización de bases de datos?
Es mejorar cómo una base de datos guarda y recupera la información, mediante el diseño del esquema, los índices, el ajuste de consultas, la caché y el escalado, para que la app siga siendo rápida a medida que crecen los usuarios y los datos.
¿Una app móvil debe usar SQL o NoSQL?
Las bases de datos SQL como PostgreSQL son ideales para datos estructurados y transacciones; las NoSQL como MongoDB, para datos flexibles o muy voluminosos. Muchas apps usan ambas.
¿Cuál es la forma más rápida de acelerar una base de datos lenta?
Encuentra las consultas más lentas con EXPLAIN y el registro de consultas lentas de la base de datos, agrega los índices adecuados y guarda en caché los datos que se leen con frecuencia en Redis o un almacén similar.
¿Cuándo debo aplicar sharding a mi base de datos?
Solo cuando un servidor ya no pueda con tus escrituras o con el volumen de datos. Prueba primero con índices, caché, réplicas de lectura y un servidor más grande, porque el sharding agrega complejidad.
¿Cuánto cuesta desarrollar una app con mucho tráfico?
Depende de las funcionalidades y de la carga esperada. Una app a medida de Appkodes, con su base de datos diseñada para escalar, cuesta desde $8,000, y la mayoría de las primeras versiones salen en vivo en unos 30 días.

Arun Andiselvam
LinkedInSoy un emprendedor que ha creado cinco marcas. Vendí la primera, una herramienta de SEO, en una operación de seis cifras, y hoy dirijo Appkodes, donde creamos apps móviles y web a medida para fundadores y empresas. Financié cada una de ellas por mi cuenta desde el primer día.