
Bem-vindo ao mundo dos aplicativos móveis, onde lidar com tráfego pesado e volumes enormes de dados é tão desafiador quanto fazer malabarismo com uma dúzia de bolas ao mesmo tempo!
A complexidade de manter os apps funcionando também aumenta, principalmente em apps sociais, de streaming ou marketplaces com uma grande base de usuários, como qualquer empresa de desenvolvimento de apps móveis vai confirmar. Os usuários também se preocupam com como proteger apps móveis e com uma boa experiência de uso.
É aí que entra a otimização de banco de dados. Ela dá ao seu software mais desempenho e escala, o que melhora a experiência do usuário. E também responde à sua dúvida sobre como melhorar o desempenho de um app móvel.
Agora vamos entrar na parte central deste guia: a otimização de banco de dados em apps móveis populares. Vamos falar dos problemas que surgem com grandes volumes de dados, de como deixar as queries mais rápidas e de como eliminar os gargalos incômodos que podem aparecer.
Chegou a hora de lançar seu app para o mundo e ver os usuários navegando pelo seu universo digital com um grande sorriso no rosto.
Pilares fundamentais da otimização de banco de dados
A otimização de banco de dados se apoia em vários pilares, todos igualmente importantes para desempenho, escalabilidade e eficiência. Veja os principais a seguir.
1. Normalização
Normalizar é, basicamente, organizar os dados em tabelas que façam sentido e eliminar a duplicação de dados.
O principal objetivo da normalização é evitar redundância de dados e eliminar dependências indevidas. Assim, a integridade dos dados melhora e o risco de anomalias durante a manipulação dos dados diminui.
Primeira Forma Normal (1NF): as colunas de tabelas em 1NF devem conter valores atômicos, que não podem ser divididos. Além disso, as colunas devem ter nomes distintos e cada linha deve ser única. Esse conceito impede armazenar vários valores em uma única célula e, assim, mantém os dados em formato tabular.
Segunda Forma Normal (2NF): a 2NF amplia a 1NF ao garantir que todos os atributos não chave dependam funcionalmente da chave primária completa. Ou seja, cada atributo não chave depende da chave primária inteira, e não apenas de parte dela. Isso elimina dependências parciais e remove ainda mais duplicações dos mesmos dados.
Terceira Forma Normal (3NF): a 3NF é mais um passo da normalização, que elimina a dependência transitiva. Isso significa que todos os atributos não chave devem depender apenas da chave primária, e não de outros atributos não chave. Ao remover essas relações implícitas entre atributos, ela ajuda a eliminar a repetição de dados.
2. Escolha do sistema de banco de dados
Na hora de escolher o banco de dados certo, é essencial comparar o desempenho de bancos relacionais como PostgreSQL, MySQL e SQL Server com alternativas NoSQL como MongoDB e Cassandra. A escolha depende principalmente da estrutura dos seus dados e do tipo de query que você executa.
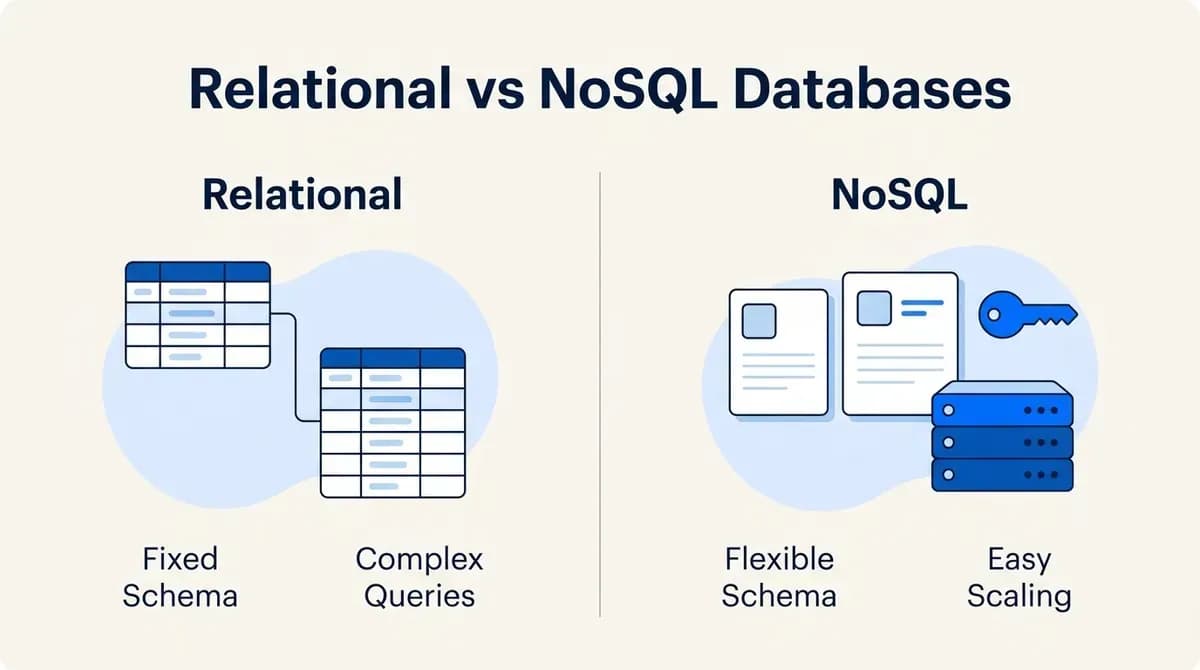
Bancos de dados relacionais (PostgreSQL, MySQL e SQL Server)
Dados estruturados: um dos grandes pontos fortes dos bancos relacionais é gerenciar dados estruturados com schemas bem definidos. Se seus dados são estruturados e você precisa criar vários relacionamentos entre entidades, os bancos relacionais são a melhor opção.
Conformidade ACID: ACID (Atomicidade, Consistência, Isolamento, Durabilidade): as propriedades garantidas por esses sistemas asseguram a integridade dos dados e a consistência das transações. Isso lhes dá vantagem em aplicações em que a integridade dos dados é crítica, como sistemas bancários e plataformas de e-commerce.
Suporte a SQL: bancos relacionais usam SQL (Structured Query Language), uma linguagem poderosa e universal para trabalhar com dados. Se sua equipe conhece SQL ou se sua aplicação precisa de queries complexas, os bancos relacionais são adequados.
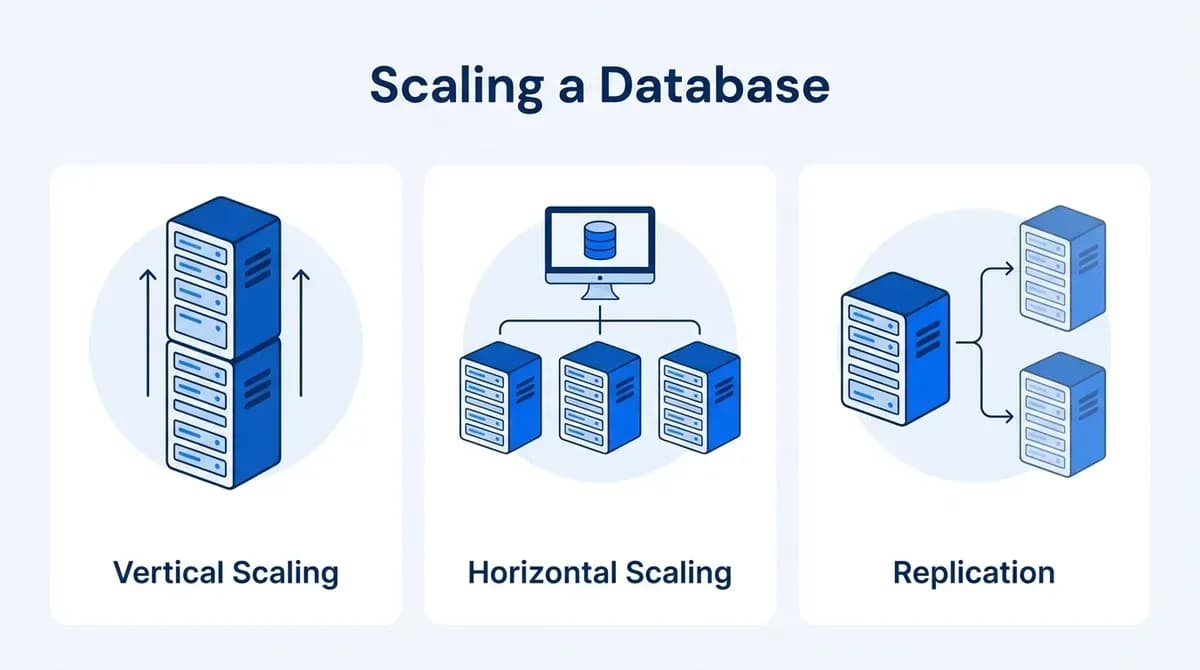
Opções NoSQL (MongoDB, Cassandra)
Schema flexível: enquanto bancos relacionais como MySQL, Oracle e PostgreSQL têm uma estrutura fixa com schemas predefinidos, bancos NoSQL como MongoDB e Cassandra oferecem schemas flexíveis para trabalhar com dados semiestruturados e não estruturados. Essa flexibilidade ajuda muito quando os requisitos mudam com frequência ou os dados são muito variados.
Escalabilidade: bancos NoSQL são projetados para escalar horizontalmente, o que os torna ideais para lidar com grandes volumes de dados e cargas de trabalho intensas. MongoDB e Cassandra são exemplos especialmente populares pela arquitetura distribuída e pela facilidade de escalar entre nós.
Padrões de query: bancos NoSQL já são otimizados para estilos específicos de query, como consultas de documentos (MongoDB), consultas wide-column (Cassandra) e buscas por chave-valor (Redis, DynamoDB). Em aplicações em que os dados ficam em formato chave-valor ou de documento, os bancos NoSQL superam os relacionais em desempenho e escalabilidade.
Ao escolher entre bancos relacionais e NoSQL, considere como são seus dados, qual é seu padrão de queries e quanto seu sistema precisa escalar.
Bancos relacionais são feitos para lidar com dados estruturados e processar queries complexas, enquanto bancos NoSQL foram pensados para oferecer flexibilidade, escalabilidade e padrões de query otimizados.
No fim, a decisão deve se basear nas necessidades e limitações específicas do seu projeto.
3. Bancos de dados distribuídos
Trata-se de uma arquitetura em que os dados ficam distribuídos entre vários servidores ou nós, em vez de ficarem armazenados em um único servidor. Essa abordagem surgiu justamente para lidar com volumes de dados muito grandes.
Volumes enormes de dados: em muitos sistemas, a quantidade de dados gerados e armazenados cresce de verdade, principalmente nos serviços web mais recentes. Um volume tão grande de informação pode superar a capacidade de um servidor de armazená-la, processá-la e gerenciá-la adequadamente.
Escalabilidade: bancos distribuídos resolvem o problema dos grandes volumes de dados ao dividir a carga de trabalho entre vários servidores ou nós. Como o sistema é distribuído, dados e processamento são compartilhados, o que permite escalar horizontalmente, adicionando servidores sempre que necessário para acompanhar o crescimento dos dados e da demanda dos usuários.
Distribuição de carga: bancos distribuídos repartem os dados e as tarefas de processamento entre vários servidores, evitando que um único servidor vire gargalo. Cada servidor do sistema fica com uma parte dos dados e do processamento e, juntos, eles gerenciam com eficiência os dados do banco e as requisições dos usuários.
Tolerância a falhas: bancos distribuídos costumam oferecer redundância e tolerância a falhas para garantir disponibilidade e confiabilidade dos dados. Se um servidor falhar ou a rede cair, o sistema continua funcionando sem interrupção, pois as operações são redirecionadas aos servidores disponíveis e a consistência dos dados é preservada.
Como fazer a otimização de banco de dados?
Os métodos fundamentais de otimização formam a base do trabalho com banco de dados. Eles ajudam as empresas a aproveitar toda a capacidade da sua infraestrutura de dados.
Uma solução é a indexação, outra é o particionamento, e cada método atua em operações diferentes para eliminar gargalos e aumentar o desempenho.
Nosso foco aqui são os princípios centrais de otimização usados na gestão de bancos de dados. Vamos ver como cada método contribui para o desempenho, a escalabilidade e a eficiência geral de um app.
Dominando essas estratégias de otimização, as empresas conseguem usar seus bancos de dados com eficiência para impulsionar inovação, agilidade e vantagem competitiva no cenário atual, orientado a dados.
Indexação
A indexação é uma técnica de otimização de banco de dados muito importante, que melhora bastante o desempenho das queries e da recuperação de dados.
Ao projetar e manter os índices do banco de acordo com os padrões de query e as necessidades de desempenho, os administradores de banco de dados conseguem equilibrar as vantagens e desvantagens da indexação.
Benefícios de uma boa indexação
Queries mais rápidas: uma coluna indexada corretamente faz as queries SELECT rodarem muito mais rápido, encurtando o tempo de busca para o usuário.
Menos varreduras completas de tabela: graças aos índices, o banco acessa rapidamente as linhas necessárias sem percorrer a tabela inteira, o que acelera a recuperação dos dados.
Mais eficiência: índices bem projetados reduzem as operações de acesso e recuperação de dados, o que aumenta a eficiência do banco.
Pontos de atenção na indexação
Escolha das colunas: decidir quais colunas indexar é importante. Colunas usadas com frequência em condições WHERE, JOINs e cláusulas ORDER BY são boas candidatas a índice.
Padrões de query: identificar os tipos de query executados no banco e para quais colunas criar índices melhora o desempenho.
Equilíbrio: a indexação pode acelerar as queries, mas criar índices demais não é uma boa ideia, porque aumenta o custo de armazenamento e deixa as escritas mais lentas. Não subestime a importância de encontrar o equilíbrio certo.
Otimização de queries
A otimização de queries é o processo de melhorar o desempenho e a eficiência das consultas ao banco de dados. Ela envolve examinar as queries e seus planos de execução para encontrar gargalos e ineficiências, e então propor e aplicar estratégias para melhorar o desempenho.
Benefícios da otimização de queries
Melhor desempenho: queries bem otimizadas respondem mais rápido, o que melhora o desempenho do sistema e reduz o tempo de espera dos usuários.
Mais escalabilidade: queries eficientes consomem menos recursos, então o sistema consegue atender mais requisições em paralelo sem perder desempenho.
Menor consumo de recursos: queries ajustadas usam menos ciclos de CPU, memória e I/O de disco, o que reduz o uso de recursos e o custo operacional.
Melhor experiência do usuário: queries mais rápidas garantem uma experiência fluida e interativa, o que deixa o público mais satisfeito e engajado.
Menor latência: queries precisas reduzem a latência ao diminuir o tempo para obter e processar os dados, gerando respostas mais rápidas para usuários e aplicações.
Ferramentas para otimização de queries
EXPLAIN: gera o plano de execução da query, descrevendo em detalhes as operações do banco, o que ajuda a localizar gargalos de desempenho e melhorar o plano de execução.
ANALYZE: coleta estatísticas sobre o uso de tabelas e índices, que ajudam a observar a distribuição dos dados e o desempenho das queries e, com isso, a identificar pontos de otimização.
Profilers de banco de dados: acompanham a atividade do banco, como queries lentas, operações que consomem muitos recursos e gargalos de desempenho, para direcionar as otimizações.
Assistentes de ajuste de queries: oferecem recomendações automáticas de otimização, como melhorias de índices, reescrita de queries e mudanças de configuração.
Visualizadores de planos de query: mostram graficamente os planos de execução, destacando as operações críticas para o desempenho e onde otimizar.
Escalando para crescer
Escalar para crescer significa aumentar a capacidade do sistema de lidar com uma carga maior. Isso pode ser feito de três formas: escalonamento vertical, escalonamento horizontal e replicação.
Cada técnica de escalonamento tem vantagens e desvantagens, que as empresas precisam analisar com cuidado para escolher a que combina com o crescimento da sua infraestrutura.
Escalonamento vertical
O que é: o escalonamento vertical, também chamado de scale up, consiste em aumentar a capacidade de um servidor adicionando mais CPU, memória ou armazenamento. Em geral, significa usar um servidor mais potente.
Limitações inerentes: o escalonamento vertical tem problemas de base; em algum momento ele esbarra em um limite, e continuar crescendo fica caro ou inviável. Além disso, um único servidor se torna um ponto único de falha, o que pode causar indisponibilidade e perda de dados.
Escalonamento horizontal (sharding)
Distribuição dos dados: o escalonamento horizontal, ou scale out, consiste em distribuir os dados entre vários servidores ou nós. O sharding é um dos métodos mais comuns de escalonamento horizontal: os dados são particionados e cada parte fica em um shard diferente, hospedado em um servidor separado.
Complexidade envolvida: o sharding traz complexidade, pois exige gerenciar a distribuição dos dados, manter a consistência entre shards e rebalancear os shards conforme o sistema cresce. Implementar e manter essa estrutura também exige planejamento e coordenação cuidadosos.
Mais throughput: por outro lado, o escalonamento horizontal resolve esse problema ao distribuir a carga entre vários servidores; assim, o sistema consegue atender mais requisições simultâneas sem sobrecarregar nenhum servidor.
Replicação
Distribuição do tráfego de leitura: para garantir alto desempenho em cenários com muitas leituras, a replicação costuma ser usada para criar réplicas do banco de dados. As réplicas de leitura absorvem as queries de leitura do banco principal, reduzindo a carga no servidor primário e contribuindo para a escalabilidade.
Vantagens em cenários de muita leitura: a replicação permite que as aplicações escalem as leituras horizontalmente entre as cópias. Assim, elas lidam com um número maior de leituras sem afetar a consistência das escritas.
Failover e alta disponibilidade: a replicação viabiliza failover e alta disponibilidade ao manter cópias dos dados em dois locais diferentes. Se o banco principal falhar, a réplica assume como principal e continua atendendo, minimizando a indisponibilidade e mantendo o serviço sem interrupções.
Considerações avançadas
A seguir, falamos dos recursos mais avançados e inovadores disponíveis para otimizar bancos de dados.
Cache
O papel do cache em memória: soluções de cache em memória, como Memcached e Redis, permitem recuperar dados rapidamente ao armazenar os dados mais acessados e os resultados das consultas ao banco.
Boas práticas: isso se faz identificando os dados mais acessados, definindo políticas de expiração adequadas e implementando mecanismos de invalidação de cache que garantam a consistência dos dados e a maior taxa possível de acertos no cache.
Compressão de dados
Uso e benefícios: a compressão alivia o gargalo de I/O de disco ao armazenar os dados em formato comprimido, o que economiza espaço e acelera a transferência de dados. Vale a pena em conjuntos de dados grandes e repetitivos, em que a economia compensa o processamento extra.
Possíveis desvantagens: embora a compressão traga ganhos de armazenamento e de I/O, ela pode gerar sobrecarga de CPU na compressão e na descompressão. Gerenciar bem os recursos de CPU e o acesso aos dados ajuda a evitar esses efeitos colaterais.
Particionamento de dados
Ganho de eficiência: particionar dados é dividir uma tabela grande em unidades lógicas com base em critérios como intervalos ou funções hash. A eficiência geral melhora porque os dados ficam distribuídos entre vários dispositivos de armazenamento ou servidores, o processamento acontece em paralelo e a contenção diminui.
Implementação ideal: boas estratégias de particionamento levam em conta os padrões de query, a frequência de acesso e o custo de manutenção, para chegar a uma distribuição equilibrada dos dados e a queries otimizadas.
Separação das análises
Bancos separados ou data warehouses: levar as análises para bancos analíticos ou data warehouses independentes dos bancos transacionais separa as duas cargas de trabalho, elimina a disputa por recursos e, com isso, garante desempenho estável para ambas.
Benefícios: ambientes analíticos dedicados contam com hardware e software otimizados para relatórios e análises complexas sobre grandes volumes de dados, sem causar indisponibilidade nos sistemas transacionais.
Opções modernas de banco de dados para apps de alto tráfego
Os fundamentos acima continuam valendo, mas os serviços gerenciados de hoje tiram boa parte do trabalho pesado das costas da sua equipe:
- Postgres serverless (Neon, Amazon Aurora Serverless): o banco aumenta e reduz a capacidade de processamento conforme o tráfego, então você paga menos nos períodos calmos e ainda aguenta os picos.
- SQL distribuído (CockroachDB, Google Spanner): tabelas relacionais e SQL, com os dados espalhados entre regiões para ganhar escala e resiliência.
- Pool de conexões (PgBouncer, RDS Proxy): apps móveis abrem muitas conexões curtas, e um pooler evita que elas sobrecarreguem o banco durante os picos.
- Caches gerenciados (serviços compatíveis com Redis, como Valkey e Amazon ElastiCache): cache em memória sem precisar manter seus próprios servidores de cache.
Métricas de desempenho e monitoramento
Métricas de desempenho e monitoramento são processos contínuos, que mantêm o banco de dados alinhado às necessidades do negócio e às expectativas de desempenho, que mudam com o tempo.
Principais métricas de desempenho
Throughput: mede o número de transações ou queries processadas por unidade de tempo, ou seja, a capacidade de vazão do banco de dados.
Latência: é o tempo que uma query ou transação leva para ser executada, que depende da velocidade de resposta do banco.
Concorrência: representa o número de operações ou queries simultâneas que um banco consegue processar por unidade de tempo sem perder velocidade.
Uso de recursos: acompanha o uso de CPU, memória, I/O de disco e rede para identificar disputa por recursos e otimizar sua alocação.
Ferramentas de monitoramento de desempenho
Ferramentas do sistema de gerenciamento de banco de dados (DBMS): a maioria dos sistemas de gerenciamento de banco de dados oferece ferramentas de monitoramento ou consoles de gestão que coletam métricas reais de desempenho em tempo real.
Soluções de monitoramento de terceiros: ferramentas de monitoramento de desempenho de bancos de dados de terceiros foram criadas para oferecer análises avançadas, sistemas de alerta e dashboards personalizados.
Importância do monitoramento de desempenho
Detecção precoce de problemas: com o monitoramento de desempenho, problemas como queries lentas, disputa por recursos ou erros de configuração são detectados antes de se tornarem falhas críticas.
Oportunidades de otimização: ao estudar as métricas de desempenho, os administradores descobrem oportunidades de otimização, de ajuste fino das configurações e de adoção de boas práticas para aumentar a eficiência do banco.
Planejamento de capacidade: acompanhar as métricas de desempenho ao longo do tempo permite planejar a capacidade e ajuda os administradores a prever as necessidades futuras de recursos para escalar a infraestrutura de forma proativa.
Boas práticas de monitoramento
Defina objetivos claros: estabeleça metas e métricas de desempenho claras, adequadas aos recursos necessários e às expectativas dos usuários da aplicação.
Monitoramento regular: acompanhe as métricas de desempenho em tempo real e reúna dados históricos para identificar tendências, anomalias e quedas de desempenho.
Alertas e notificações: configure sistemas de alerta que avisem os responsáveis sobre incidentes críticos ou métricas que fujam do padrão.
Análise de causa raiz: quando surgirem problemas de desempenho, faça uma análise completa de causa raiz para encontrar os fatores que originaram o problema e tomar medidas para resolvê-lo.
Otimização de banco de dados como um ciclo de iteração sem fim.
O processo iterativo de otimização é uma forma sistemática de aumentar a eficiência, a eficácia e a produtividade de um sistema ou processo por meio de ciclos repetidos. Essa abordagem favorece o aprendizado contínuo e a adaptação ao feedback e às métricas de desempenho, o que no fim gera melhorias incrementais e avanços.
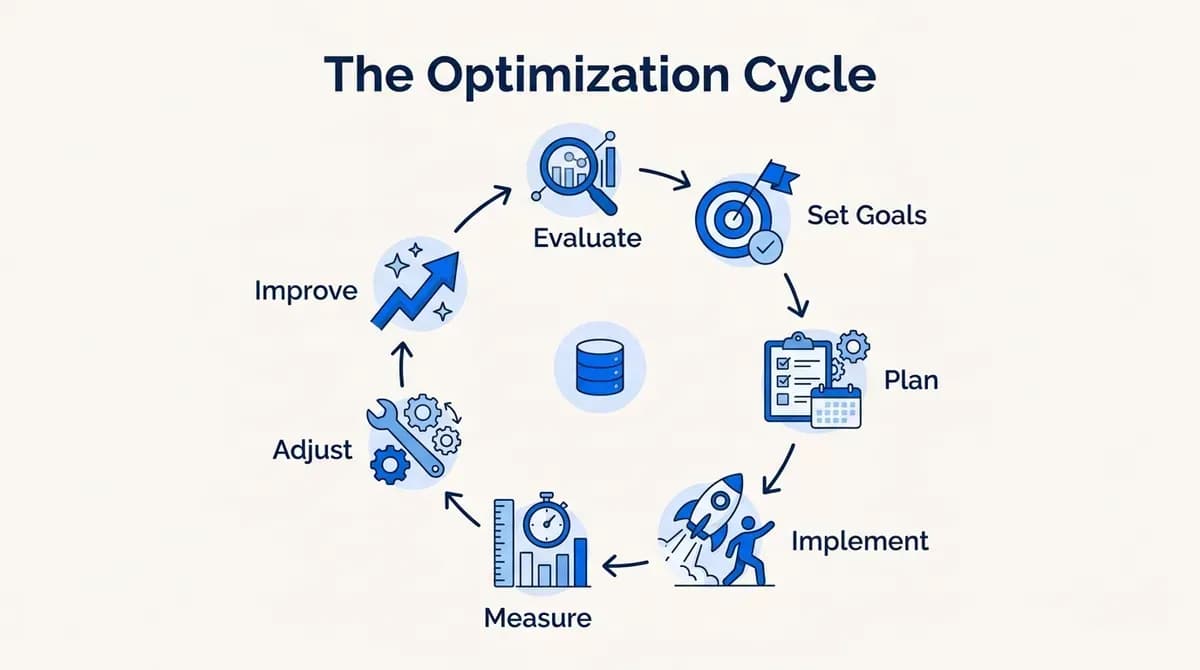
1. Avaliação e análise
Avalie o desempenho atual: avalie o desempenho do sistema analisando métricas, gargalos e limites.
Colete feedback: busque o feedback de usuários, desenvolvedores e stakeholders para entender o que os incomoda, quais são suas expectativas de desempenho e o que deve melhorar.
2. Definição de metas e prioridades
Defina as metas de otimização: estabeleça objetivos e indicadores de desempenho com base nos resultados da avaliação e nas sugestões recebidas.
Priorize os esforços de otimização: identifique os principais problemas de desempenho e ordene os esforços de otimização conforme o impacto na experiência do usuário, na estabilidade do sistema e nos objetivos do negócio.
3. Desenvolvimento da estratégia
Identifique estratégias de otimização: levante e pesquise os métodos, técnicas e boas práticas de otimização usados para resolver esses problemas de desempenho.
Adapte as estratégias às metas: ajuste as estratégias de otimização às metas definidas, às principais preocupações e às características do sistema de banco de dados.
4. Implementação e testes
Execute os planos de otimização: aplique as técnicas de otimização, as mudanças e os ajustes de desempenho no ambiente do banco de dados.
Testes e validação: teste e valide com rigor até que ponto as otimizações adotadas trouxeram as melhorias esperadas de desempenho e de eficiência operacional.
5. Monitoramento e medição
Monitore as métricas de desempenho: descubra o impacto no desempenho do banco acompanhando as métricas e indicadores críticos depois de aplicar as otimizações.
Meça os resultados: avalie o sucesso da otimização comparando os resultados com as metas e os parâmetros de desempenho definidos, destacando os pontos fortes e fracos do processo.
6. Feedback e ajustes
Colete feedback: reúna o feedback de usuários, desenvolvedores e administradores de sistema, os principais stakeholders, sobre o efeito da otimização no desempenho do sistema e na experiência do usuário.
Ajuste iterativo: com base no feedback e no monitoramento de desempenho, aplique correções sucessivas às estratégias e configurações de otimização para ajustar o funcionamento do banco e, no processo, resolver os problemas que ainda restarem.
7. Melhoria contínua
Ciclo iterativo: a otimização é um processo contínuo de avaliação, implementação, testes e ajustes.
Aprendizado contínuo: aplique o que foi aprendido em cada etapa da otimização do banco e registre esses aprendizados para garantir melhorias de desempenho em cada fase.
Conclusão
Em resumo, otimizar o banco de dados de um app móvel de alto tráfego tem como objetivo a satisfação dos usuários e um desempenho sustentável. Indexação estratégica, otimização de queries complexas, cache e técnicas de compressão de dados ajudam muito os bancos a processar grandes volumes de dados com rapidez.
Técnicas de escalonamento como o sharding (horizontal) reforçam a escalabilidade, enquanto o monitoramento em tempo real sustenta a otimização contínua do desempenho. Assim, a otimização e o refinamento iterativo do banco de dados acompanham as demandas de um app com alto tráfego móvel.
No fim, um banco de dados bem projetado é o que permite que um app móvel continue crescendo sem ficar lento. Um app móvel sob medida da Appkodes, com o banco de dados projetado para alto tráfego desde a primeira versão, começa em $8,000, com um plano orçado a preço fixo antes do início do trabalho, e a maioria das primeiras versões entra no ar em cerca de 30 dias.
Perguntas frequentes
O que é otimização de banco de dados?
É melhorar a forma como um banco de dados armazena e recupera dados, com design de schema, índices, ajuste de queries, cache e escalabilidade, para que o app continue rápido à medida que usuários e dados crescem.
Um app móvel deve usar SQL ou NoSQL?
Bancos SQL como o PostgreSQL são ideais para dados estruturados e transações; bancos NoSQL como o MongoDB atendem bem dados flexíveis ou muito volumosos. Muitos apps usam os dois.
Qual é a forma mais rápida de acelerar um banco de dados lento?
Encontre as queries mais lentas com EXPLAIN e com o log de queries lentas do banco, crie os índices certos e coloque em cache os dados lidos com frequência no Redis ou em um serviço parecido.
Quando devo fazer sharding do meu banco de dados?
Só quando um único servidor não der mais conta das escritas ou do volume de dados. Antes, tente índices, cache, réplicas de leitura e um servidor maior, porque o sharding adiciona complexidade.

Arun Andiselvam
LinkedInSou um empreendedor que já criou cinco marcas. Vendi a primeira, uma ferramenta de SEO, num negócio de seis dígitos, e hoje lidero a Appkodes, criando apps móveis e web sob medida para fundadores e empresas. Financiei cada uma delas por conta própria desde o primeiro dia.
